








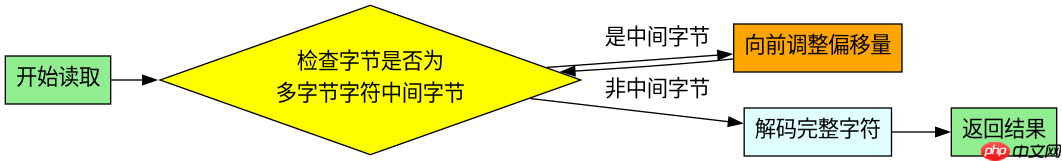
使用 system.text.encoding.utf8.getstring 将字节流转换为字符串,然后直接按字符索引截取,即可避免从字符中间开始。utf-8 编码中多字节字符的起始字节最高位为1,结束或中间字节最高位为0,通过检查字节高位可以判断是否处于字符边界。如果当前字节是某个多字节字符的中间部分,则向前移动直到找到字符起始位置,再读取完整字符。
如何检测字节流中的 UTF-8 字符边界?
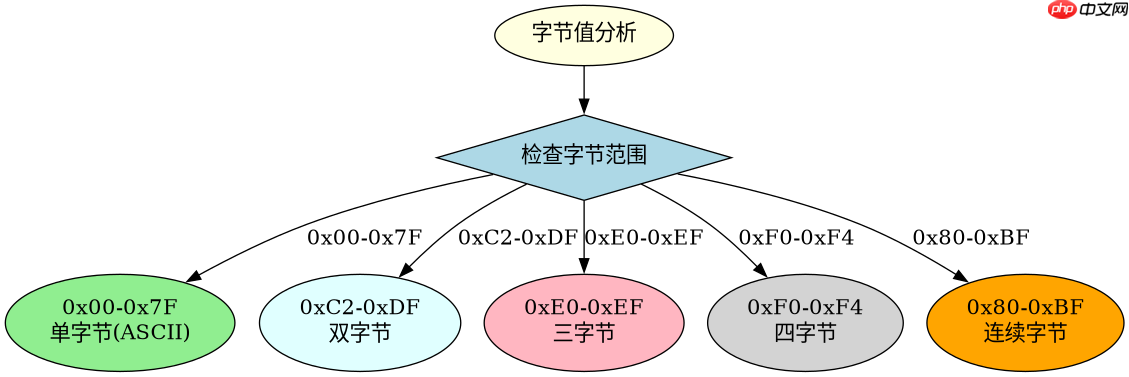
UTF-8 编码规定:单字节字符(ASCII)范围是 0x00-0x7F;双字节字符首字节范围是 0xC2-0xDF;三字节字符首字节范围是 0xE0-0xEF;四字节字符首字节范围是 0xF0-0xF4。通过检查目标位置的字节值,可以判断该位置是否是字符的起始点。如果目标字节属于多字节字符的非首字节(即 0x80-0xBF 范围),则需要向前查找直到找到首字节。

using System;
using System.Text;

public class Utf8Reader
{
    public static string ReadAtFixedPosition(byte[] data, int byteOffset)
    {
        if (byteOffset < 0 || byteOffset >= data.Length)
            throw new ArgumentOutOfRangeException(nameof(byteOffset));

        // 检查是否为多字节字符的中间字节
        while (byteOffset < data.Length && IsContinuationByte(data[byteOffset]))
        {
            byteOffset--;
        }

        // 重新计算有效偏移
        if (byteOffset < 0) byteOffset = 0;

        // 获取剩余字节并解码
        int remainingLength = data.Length - byteOffset;
        return Encoding.UTF8.GetString(data, byteOffset, remainingLength);
    }

    private static bool IsContinuationByte(byte b)
    {
        return (b & 0xC0) == 0x80;
    }
}

// 测试代码
var text = "Hello 世界";
var bytes = Encoding.UTF8.GetBytes(text);
Console.WriteLine($"原始文本: {text}");
Console.WriteLine($"字节数组长度: {bytes.Length}");

// 尝试从第6个字节开始读取("世"的起始位置)
string result1 = Utf8Reader.ReadAtFixedPosition(bytes, 6);
Console.WriteLine($"从位置6读取: '{result1}'");

// 尝试从第7个字节开始读取("世"的第二个字节)
string result2 = Utf8Reader.ReadAtFixedPosition(bytes, 7);
Console.WriteLine($"从位置7读取: '{result2}'");

// 预期输出:
// 原始文本: Hello 世界
// 字节数组长度: 10
// 从位置6读取: '世界'
// 从位置7读取: '界'(自动调整到字符边界)
如何处理不同长度的 UTF-8 字符?
UTF-8 支持1到4字节的字符编码。中文汉字通常使用3字节编码,但某些生僻字可能使用4字节。在读取时,需要确保读取的字节数能够构成完整的字符。可以通过检查首字节来确定后续需要读取的字节数:0xC0-0xDF 表示2字节字符,0xE0-0xEF 表示3字节字符,0xF0-0xF7 表示4字节字符。这样可以在固定位置读取时,准确识别字符边界并读取完整字符。

using System;
using System.Text;

public class PreciseUtf8Reader
{
    public static string ReadCompleteCharAt(byte[] data, int byteOffset)
    {
        if (byteOffset < 0 || byteOffset >= data.Length)
            throw new ArgumentOutOfRangeException(nameof(byteOffset));

        // 如果是连续字节,向前查找字符起始位置
        while (byteOffset > 0 && IsContinuationByte(data[byteOffset]))
        {
            byteOffset--;
        }

        // 确定字符长度
        int charLength = GetUtf8CharLength(data[byteOffset]);

        // 检查是否有足够字节
        if (byteOffset + charLength > data.Length)
            throw new InvalidOperationException("Not enough bytes for complete character");

        // 提取并解码完整字符
        return Encoding.UTF8.GetString(data, byteOffset, charLength);
    }

    private static int GetUtf8CharLength(byte firstByte)
    {
        if ((firstByte & 0x80) == 0x00) return 1; // ASCII
        if ((firstByte & 0xE0) == 0xC0) return 2; // 2-byte
        if ((firstByte & 0xF0) == 0xE0) return 3; // 3-byte
        if ((firstByte & 0xF8) == 0xF0) return 4; // 4-byte
        throw new ArgumentException("Invalid UTF-8 start byte");
    }

    private static bool IsContinuationByte(byte b)
    {
        return (b & 0xC0) == 0x80;
    }
}

// 测试代码
var text = "Hello 世界?";
var bytes = Encoding.UTF8.GetBytes(text);
Console.WriteLine($"原始文本: {text}");
Console.WriteLine($"字节数组长度: {bytes.Length}");

// 从"世"的位置开始读取
int worldStart = 6; // "世"的起始位置
string char1 = PreciseUtf8Reader.ReadCompleteCharAt(bytes, worldStart);
Console.WriteLine($"从位置{worldStart}读取: '{char1}'");

// 从"?"的中间位置开始读取(假设在第15个字节)
int emojiMiddle = 15;
try
{
    string char2 = PreciseUtf8Reader.ReadCompleteCharAt(bytes, emojiMiddle);
    Console.WriteLine($"从位置{emojiMiddle}读取: '{char2}'");
}
catch (Exception ex)
{
    Console.WriteLine($"错误: {ex.Message}");
}

// 预期输出:
// 原始文本: Hello 世界?
// 字节数组长度: 16
// 从位置6读取: '世'
// 从位置15读取: '?'(自动调整到字符边界)
当读取位置正好在多字节字符中间时会发生什么?
当读取位置正好位于多字节字符的中间字节时,程序会自动向前查找直到找到字符的起始位置。例如,如果"世"字由三个字节组成,而读取位置指向第二个字节,程序会向前移动到第一个字节,然后读取完整的三个字节的"世"字。这种机制确保了不会出现乱码或截断的字符,保证了文本的完整性。对于ASCII字符(单字节),由于没有多字节结构,读取位置不会影响结果。


















