








java iterator 遍历 hashset 的顺序是不确定的,每次运行结果可能不同。这是因为 hashset 基于 hashmap 实现,其内部元素存储位置取决于哈希值、哈希表容量和扩容机制,而非插入顺序。要获得可预测的遍历顺序,应改用 linkedhashset(保持插入顺序)或 treeset(自然排序)。

为什么 HashSet 的遍历顺序是随机的?
因为 HashSet 底层由 HashMap 支撑,元素在数组中的位置由 hashCode() 决定,且受负载因子影响会触发 rehash 导致索引变化。因此遍历时按桶索引扫描,顺序看似随机但实际由哈希算法固定于当前状态。
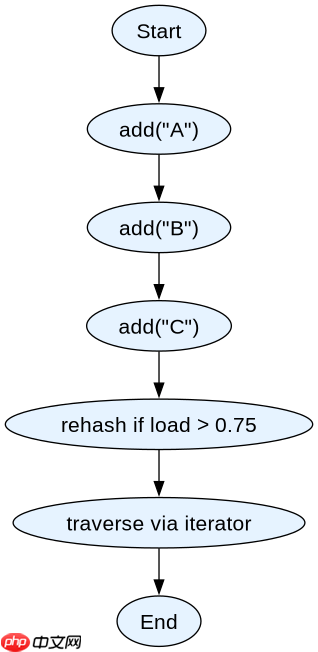
import java.util.*;

public class Main {
    public static void main(String[] args) {
        Set<String> set = new HashSet<>();
        set.add("A");
        set.add("B");
        set.add("C");
        for (String s : set) {
            System.out.print(s + " ");
        }
    }
}
预期输出示例:C B A (具体顺序因 JVM 版本和哈希实现而异,但非插入序)
立即学习“Java免费学习笔记(深入)”;

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何确保遍历顺序与插入顺序一致?
使用 LinkedHashSet 替代 HashSet,它通过维护双向链表记录插入顺序,Iterator 遍历时按该链表返回元素,保证顺序稳定。

import java.util.*;

public class Main {
    public static void main(String[] args) {
        Set<String> set = new LinkedHashSet<>();
        set.add("A");
        set.add("B");
        set.add("C");
        for (String s : set) {
            System.out.print(s + " ");
        }
    }
}
预期输出:A B C
当向已包含相同元素的 HashSet 添加重复项时,Iterator 行为如何?
添加重复元素不会改变集合内容,Iterator 仍只遍历唯一元素,顺序不变。例如对含 {"A","B"} 的 HashSet 再次 add("A"),集合大小仍为 2,遍历结果仍是两个元素,无新增或重复。



















