








java 中 int 和 long 的取值范围区分主要依据它们占用的字节数和符号位:int 是 32 位有符号整数,范围约为 ±21 亿;long 是 64 位有符号整数,范围约为 ±9.22 京。在代码中,直接声明变量时 int 默认无后缀,而 long 必须加 l 后缀。若数值超出 int 范围,编译器会报错,此时需改用 long 并添加后缀。
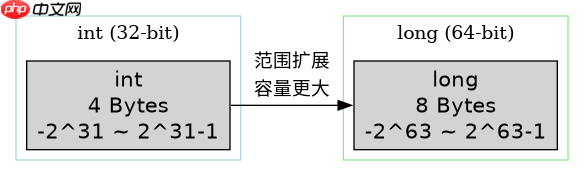
int 类型的存储结构与溢出表现
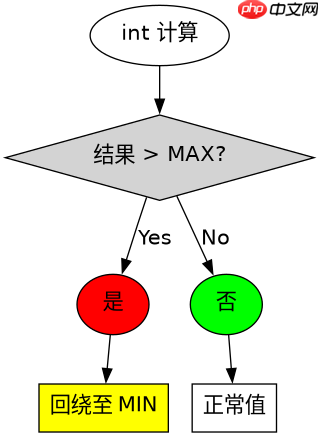
int 类型在 Java 中固定占用 4 个字节(32 位),采用补码表示法。其最大值为 Integer.MAX_VALUE(即 2^31 - 1),最小值为 Integer.MIN_VALUE(即 -2^31)。当计算结果超过这个范围时,会发生溢出,导致数值回绕到另一端。例如,最大值加 1 会变成最小值。这种特性使得在处理大数或累加计数时需格外小心,避免静默错误。
public class IntRangeDemo {
    public static void main(String[] args) {
        // 定义 int 的最大值和最小值
        int maxInt = Integer.MAX_VALUE;
        int minInt = Integer.MIN_VALUE;

        System.out.println("int 最大值: " + maxInt);
        System.out.println("int 最小值: " + minInt);

        // 演示溢出:最大值加 1
        int overflowResult = maxInt + 1;
        System.out.println("最大值 + 1 (溢出): " + overflowResult);

        // 尝试赋值超出 int 范围的常量(编译错误示例)
        // int badValue = 3000000000; // 编译报错:可能损失精度
    }
}
运行上述代码,输出结果为:
int 最大值: 2147483647
int 最小值: -2147483648
最大值 + 1 (溢出): -2147483648
这证实了 int 在达到上限后会自动回绕到下限,符合补码运算规则。
long 类型的扩展范围与字面量规范
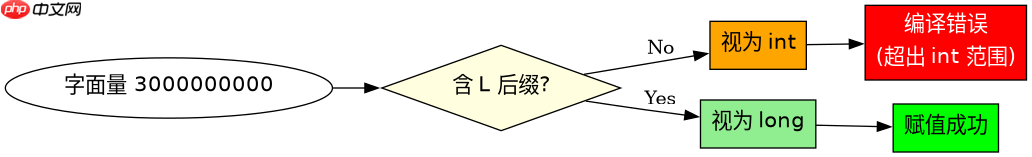
long 类型占用 8 个字节(64 位),范围远大于 int,最大值为 Long.MAX_VALUE(约 9.22 * 10^18),最小值为 Long.MIN_VALUE。在 Java 源码中,任何整数字面量默认被视为 int 类型。若要表示一个 long 类型的字面量,必须在数字末尾添加 L 或 l 后缀,推荐使用大写 L 以避免与数字 1 混淆。这是区分两者在代码书写层面的关键差异。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
public class LongRangeDemo {
    public static void main(String[] args) {
        // 定义 long 的最大值和最小值
        long maxLong = Long.MAX_VALUE;
        long minLong = Long.MIN_VALUE;

        System.out.println("long 最大值: " + maxLong);
        System.out.println("long 最小值: " + minLong);

        // 正确声明 long 字面量
        long bigNumber = 3000000000L; // 注意 L 后缀
        System.out.println("大数赋值: " + bigNumber);

        // 错误示范:不加 L 后缀会导致编译错误
        // long errorNumber = 3000000000; // 编译报错:整数太大
    }
}
运行结果:
long 最大值: 9223372036854775807
long 最小值: -9223372036854775808
大数赋值: 3000000000
可见,通过添加 L 后缀,成功将超出 int 范围的数值赋给 long 变量,且未发生溢出。
基于程序中某个输入、条件或结果的具体问题
在之前的代码示例中,我们使用了 3000000000L 作为 long 的输入。如果去掉 L 后缀,直接写 3000000000,编译器会将其视为 int 字面量。由于 30 亿大于 Integer.MAX_VALUE(21 亿),编译器会抛出“可能损失精度”的错误。这一现象明确了区分 int 和 long 的实际操作要点:当数值字面量超过 21 亿时,必须显式使用 long 类型及后缀,否则无法通过编译。这是开发者在日常编码中最常遇到的边界条件。


















