








分析 cms 垃圾回收日志的核心在于识别 concurrent mode failure 和 premature concurrent marking 这两个关键事件,并据此调整堆内存大小或并行度。通过观察 [gc (allocation failure) 到 [full gc (cms) 的转换,可以判断是否发生了从并发模式退化到串行全量回收的情况。若发现频繁的 full gc,通常意味着老年代空间不足或并发标记线程跟不上对象分配速度。

CMS 各阶段日志标识与含义是什么
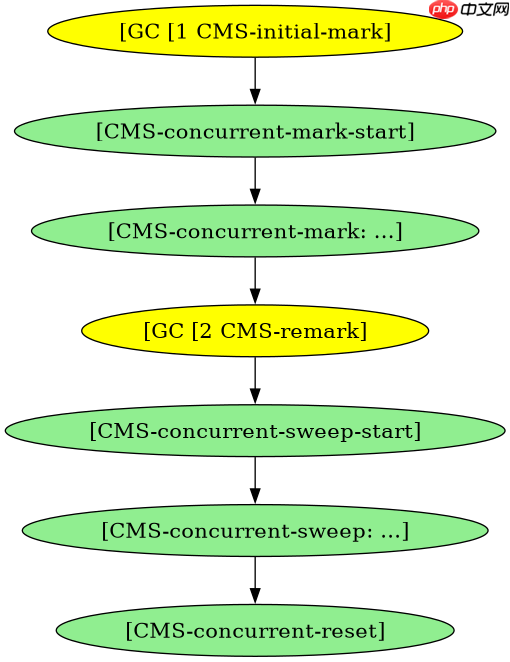
CMS 回收过程分为初始标记、并发标记、重新标记和并发清理四个主要阶段,每个阶段在日志中都有明确的标识。初始标记阶段会短暂停顿(STW),日志显示为 [GC [1 CMS-initial-mark];并发标记阶段不暂停应用,日志显示为 [CMS-concurrent-mark-start] 和 [CMS-concurrent-mark: ...];重新标记阶段再次 STW,日志显示为 [GC [2 CMS-remark];最后并发清理阶段也是非阻塞的,日志显示为 [CMS-concurrent-sweep-start] 和 [CMS-concurrent-reset]。理解这些标签有助于定位停顿时间长的具体环节。
import java.util.ArrayList;
import java.util.List;

public class CmsLogDemo {
    public static void main(String[] args) {
        List<byte[]> list = new ArrayList<>();
        // 模拟对象分配,触发 GC
        for (int i = 0; i < 1000000; i++) {
            list.add(new byte[1024 * 10]); // 10KB
        }
        System.out.println("Done");
    }
}
如何判断 CMS 是否发生了并发模式失败
当老年代空间不足以容纳新分配的对象时,CMS 会放弃当前的并发清理过程,转而启动 Serial Old 收集器进行串行全量回收,这就是并发模式失败。日志中会出现 [Full GC (Ergonomics) 或者明确标注 CMS-concurrent-abort-before-full。这种情况会导致长时间的 Stop-The-World 停顿,严重影响系统性能。解决思路通常是增加堆内存或提高 CMS 并发线程数。

KeystoneJS 是一个功能强大的开源无头 CMS,适用于 Node.js,它根据您的模式定义自动生成 GraphQL API 和基于 React 的管理界面。由 Thinkmill 构建,支持 PostgreSQL 和 SQLite、自定义访问控制、钩子、虚拟字段和基于文档的富文本编辑。
立即学习“Java免费学习笔记(深入)”;

// 验证并发模式失败的输入条件
// JVM Args: -Xms10m -Xmx10m -XX:+UseConcMarkSweepGC -XX:+PrintGCDetails
// 当堆内存极小时,快速分配对象会直接触发 Full GC
public class CmsFailureTest {
    public static void main(String[] args) {
        try {
            while (true) {
                new byte[1024 * 500]; // 500KB
            }
        } catch (OutOfMemoryError e) {
            e.printStackTrace();
        }
    }
}
基于 CMS 日志中的停顿时间如何优化参数
如果日志显示 CMS-concurrent-mark 阶段耗时过长,说明并发标记线程可能无法及时完成工作,导致后续重新标记阶段压力增大。此时可以通过调整 -XX:ConcGCThreads 来增加并发线程数,加速标记过程。如果 CMS-remark 停顿时间过长,则可能需要调整 -XX:CMSInitiatingOccupancyFraction,让 CMS 更早地触发回收,避免老年代过于拥挤。通过监控这些阶段的持续时间,可以针对性地调优 JVM 参数。


















