








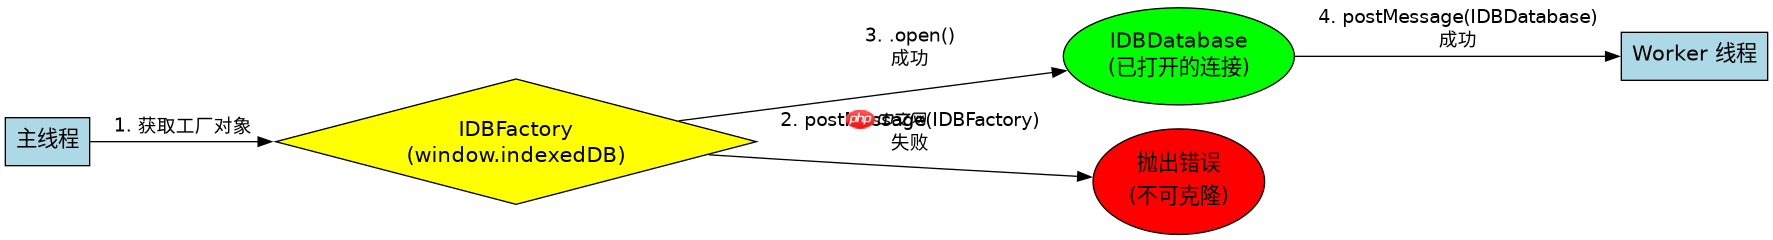
javascript web worker 无法直接传递 idbfactory 实例,因为数据库连接对象不支持结构化克隆算法。正确的做法是在主线程中打开数据库并建立 idbdatabase 连接,然后通过 postmessage 将该连接对象传递给 worker,worker 端接收后直接使用即可。
为什么 IDBFactory 不能跨线程传递
Web Workers 与主线程之间的通信基于结构化克隆算法(Structured Clone Algorithm)。该算法支持大多数原生 JavaScript 类型,但明确排除了 DOM 对象和某些特定的浏览器 API 对象,其中就包括 IndexedDB 相关的接口。当你尝试将 IDBFactory(即全局的 window.indexedDB)或 IDBOpenDBRequest 等对象通过 postMessage 发送时,序列化过程会失败,导致抛出错误。这是因为数据库连接涉及到底层的资源句柄和事务状态,这些状态在多线程环境下需要严格的隔离和管理,直接共享底层指针会导致数据竞争和不一致。
const worker = new Worker('worker.js');

// 1. 在主线程获取 IDBFactory
const factory = window.indexedDB;

// 2. 尝试直接发送工厂对象(这会失败)
try {
    worker.postMessage(factory);
} catch (e) {
    console.error('Failed to post IDBFactory:', e);
}

// 3. 正确做法:先打开数据库,再发送连接
factory.open('MyDatabase', 1).then((db) => {
    // 发送 IDBDatabase 实例
    worker.postMessage(db);
});
上述代码展示了错误的尝试路径。当执行 worker.postMessage(factory) 时,浏览器引擎会尝试对 IDBFactory 进行深拷贝,但由于其内部包含非克隆able 的资源引用,操作会立即中断。相比之下,IDBDatabase 虽然也是浏览器特定对象,但在现代浏览器实现中,它被允许作为消息的一部分进行传递,前提是它已经处于打开状态且没有正在进行的事务阻塞。这种设计允许 Worker 拥有独立的数据库连接句柄,从而可以在后台线程中执行读写操作,而不会阻塞主线程的 UI 渲染。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何在 Worker 中安全使用传递来的数据库连接
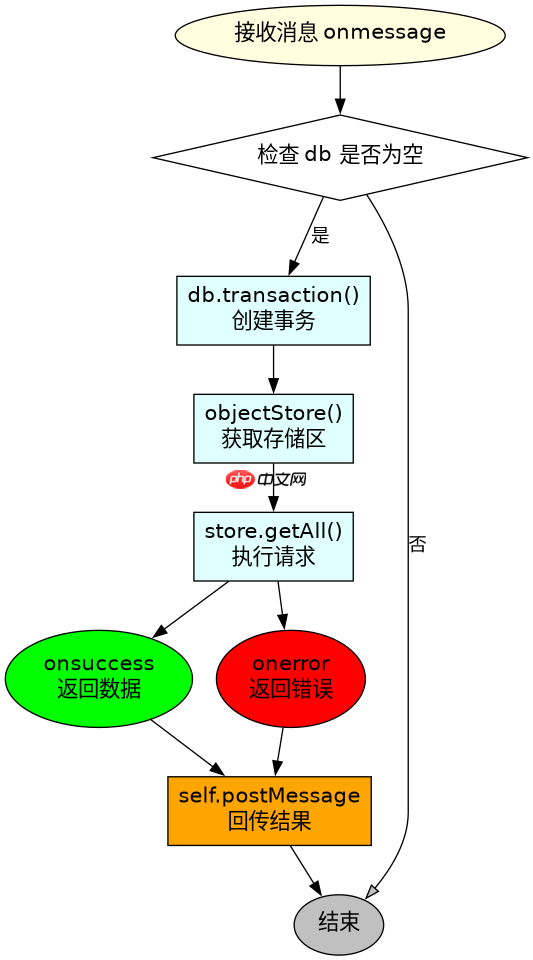
一旦 IDBDatabase 连接被成功传递到 Worker 内部,开发者就可以像在主线程中一样使用它来创建事务和请求数据。关键在于确保 Worker 中的数据库操作是异步的,并且正确处理回调或 Promise 链。由于 Worker 运行在独立的执行上下文中,它对数据库的操作不会影响主线程的响应性,这是使用 Web Workers 处理大量 IndexedDB 数据的核心优势。

// worker.js
self.onmessage = function(e) {
    const db = e.data;

    if (!db) return;

    // 创建一个只读事务
    const transaction = db.transaction(['items'], 'readonly');
    const store = transaction.objectStore('items');
    const request = store.getAll();

    request.onsuccess = function() {
        // 处理结果
        self.postMessage({ type: 'data', payload: request.result });
    };

    request.onerror = function() {
        self.postMessage({ type: 'error', payload: request.error });
    };
};
在 Worker 代码中,我们监听 onmessage 事件以接收来自主线程的消息。接收到 db 对象后,我们立即调用 db.transaction() 方法。这里需要注意,IDBDatabase 对象本身是不可变的配置快照,因此多次从同一个传递过来的 db 对象创建新的事务是安全的。每个事务都会产生新的 IDBTransaction 和 IDBObjectStore 实例。如果需要在 Worker 中进行写操作,只需将事务模式改为 'readwrite' 即可。最后,通过 self.postMessage 将查询结果或错误信息回传给主线程,完成整个数据交互闭环。
如果需要在 Worker 中独立打开数据库怎么办
在某些架构下,你可能希望 Worker 完全自治,不依赖主线程传递连接。此时,Worker 可以使用自己的 indexedDB 全局对象来独立打开数据库。虽然主线程和 Worker 访问的是同一个物理数据库文件,但它们各自维护独立的连接池和事务上下文。这种方式避免了跨线程传递大对象或复杂状态的开销,适合长期运行的后台任务。
// worker.js - 独立打开数据库
const DB_NAME = 'MyDatabase';
const DB_VERSION = 1;

function initDB() {
    return new Promise((resolve, reject) => {
        const request = indexedDB.open(DB_NAME, DB_VERSION);

        request.onupgradeneeded = (e) => {
            const db = e.target.result;
            if (!db.objectStoreNames.contains('items')) {
                db.createObjectStore('items', { keyPath: 'id' });
            }
        };

        request.onsuccess = () => resolve(request.result);
        request.onerror = () => reject(request.error);
    });
}

initDB().then(db => {
    // 现在可以在 Worker 内部自由使用 db
    const tx = db.transaction('items', 'readwrite');
    tx.objectStore('items').add({ id: 1, value: 'test' });
});
这种独立打开的方式利用了每个 Worker 线程都拥有独立的 indexedDB 接口的特性。尽管逻辑上它们指向同一个数据库,但物理连接是分离的。这意味着你可以在 Worker 中执行长时间运行的事务,而不用担心主线程关闭了连接或发生了版本升级冲突。只要两个线程不尝试同时修改同一组数据而不加锁,这种并行访问就是安全的。对于简单的读取场景,这种解耦架构更加健壮,因为它消除了主线程与 Worker 之间关于数据库生命周期的耦合。

















