








使用 datainputstream 的 readutf() 方法可以直接读取由 dataoutputstream.writeutf() 写入的 utf-8 编码字符串。调用该方法时,流会自动读取两个字节作为长度前缀,随后按该长度读取并解码字符数据,返回完整的 java 字符串对象。
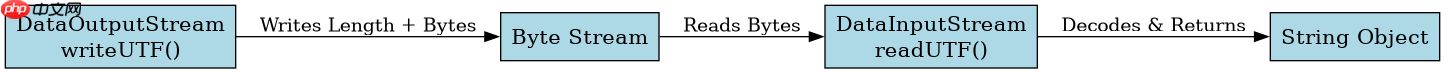
writeUTF() 写入的数据结构是怎样的
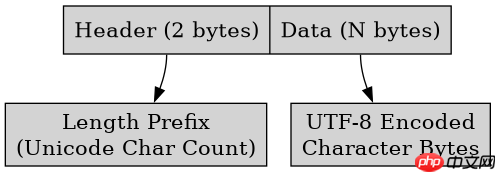
writeUTF() 在写入字符串时,会先写入一个无符号的短整型(2 个字节)表示字符串中 Unicode 字符的数量,接着写入每个字符对应的 UTF-8 编码字节。这种格式确保了读取端能准确知道要读取多少字节来还原字符串。
import java.io.*;

public class WriteUtfDemo {
    public static void main(String[] args) throws Exception {
        ByteArrayOutputStream baos = new ByteArrayOutputStream();
        DataOutputStream dos = new DataOutputStream(baos);
        String text = "Hello";
        dos.writeUTF(text);
        byte[] data = baos.toByteArray();
        System.out.println("Length prefix: " + (data[0] << 8 | data[1]));
        System.out.println("Bytes: " + java.util.Arrays.toString(data));
    }
}
运行上述代码,预期输出显示长度前缀为 5,后续字节为 "Hello" 的 UTF-8 编码值。这验证了写入结构包含长度头和数据体。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
读取时如何处理非 UTF-8 或损坏数据
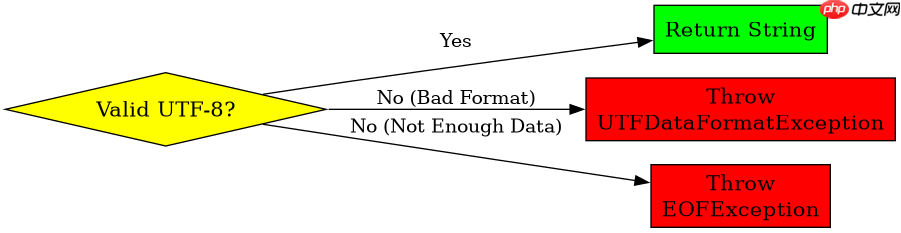
当输入流中的数据不是由 writeUTF() 生成,或者在传输过程中发生损坏时,readUTF() 的行为取决于具体错误类型。如果长度前缀指向的字节数不足,会抛出 EOFException;如果字节序列不符合 UTF-8 规范,则抛出 UTFDataFormatException。它不会静默失败,而是强制要求数据完整性。
import java.io.*;

public class ReadUtfErrorDemo {
    public static void main(String[] args) throws Exception {
        // 模拟损坏数据:长度前缀说有两个字符,但只有一个字节
        byte[] badData = {(byte) 0x00, 0x02, (byte) 0xFF};
        ByteArrayInputStream bais = new ByteArrayInputStream(badData);
        DataInputStream dis = new DataInputStream(bais);
        try {
            dis.readUTF();
        } catch (UTFDataFormatException e) {
            System.out.println("Caught UTFDataFormatException");
        } catch (EOFException e) {
            System.out.println("Caught EOFException");
        }
    }
}
执行此测试程序,由于提供的字节序列无法构成合法的 UTF-8 字符,程序将捕获 UTFDataFormatException。这表明在处理不可信来源的数据时,必须对 readUTF() 进行异常处理。
读取特定长度的字符串结果是什么
如果通过 writeUTF() 写入一个包含特殊字符或空字符串的实例,readUTF() 会原样还原。例如,写入空字符串时,长度前缀为 0,读取后得到空字符串 ""。写入包含中文的字符串时,长度前缀计算的是字符数而非字节数,读取后正确返回中文字符串。这一行为保证了跨平台数据交换的一致性。



















