








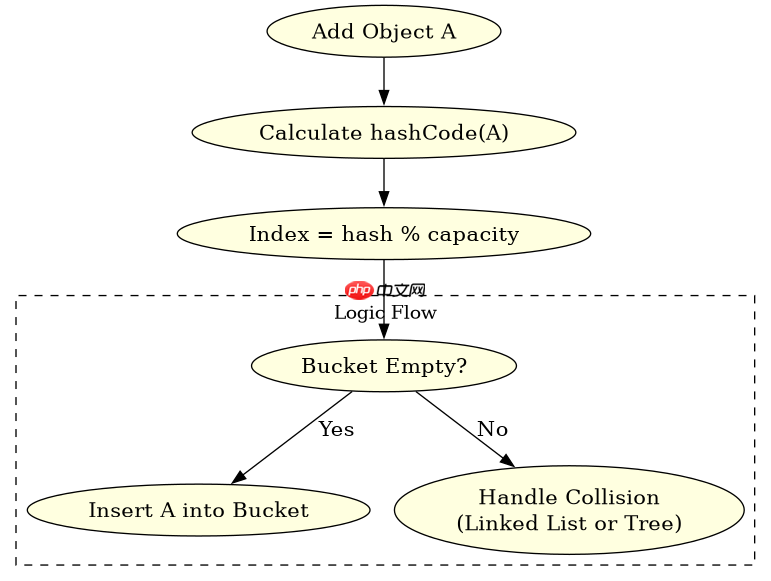
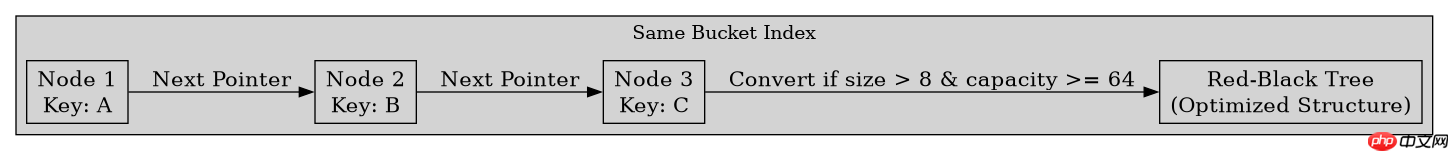
java hashset 的存储原理基于 hashmap,其核心机制是利用哈希表处理键值对。当多个元素计算出的哈希码相同(即发生哈希冲突)时,hashset 会在同一个桶位上通过链表或红黑树来存储这些元素,确保所有数据都能被保留且通过 equals() 方法区分。

hashCode() 如何决定初始存储位置
HashSet 在添加元素时,首先调用对象的 hashCode() 方法获取哈希值,并通过特定的扰动函数处理后映射到数组索引。这个索引决定了元素初步存放的“桶”位置。如果该位置为空,元素直接存入;如果不为空,则说明发生了潜在的哈希冲突,需要进一步处理。
import java.util.HashSet;
import java.util.Objects;

public class Person {
    private String name;
    private int age;

    public Person(String name, int age) {
        this.name = name;
        this.age = age;
    }

    @Override
    public boolean equals(Object o) {
        if (this == o) return true;
        if (o == null || getClass() != o.getClass()) return false;
        Person person = (Person) o;
        return age == person.age && Objects.equals(name, person.name);
    }

    @Override
    public int hashCode() {
        return Objects.hash(name, age);
    }

    public static void main(String[] args) {
        HashSet<Person> set = new HashSet<>();
        // 模拟两个不同对象但哈希冲突的情况(需手动构造特定哈希值或依赖JVM实现)
        // 这里演示正常添加过程
        set.add(new Person("Alice", 30));
        set.add(new Person("Bob", 25));
        System.out.println(set.size()); // 输出 2
    }
}
哈希冲突发生时链表与红黑树的转换逻辑
当多个元素落入同一个桶位时,HashSet 内部使用链表结构连接这些节点。从 Java 8 开始,如果链表长度超过阈值(默认为 8)且数组长度达到 64,链表会转换为红黑树以提高查找效率。这种设计保证了在最坏情况下查找时间复杂度仍为 O(log n),而非链表的 O(n)。

FilePond 灵活的 JavaScript 文件上传库
下载
FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
立即学习“Java免费学习笔记(深入)”;
import java.util.HashSet;
import java.util.Iterator;

public class ConflictDemo {
    public static void main(String[] args) {
        HashSet<String> set = new HashSet<>();
        set.add("apple");
        set.add("banana");
        set.add("cherry");

        // 遍历验证存储
        Iterator<String> it = set.iterator();
        while(it.hasNext()) {
            System.out.println(it.next());
        }
    }
}
为什么必须同时重写 hashCode() 和 equals()
如果在自定义类中只重写了 equals() 而未重写 hashCode(),会导致逻辑上的不一致。因为 HashSet 依赖 hashCode() 快速定位桶位,若两个逻辑相等的对象具有不同的哈希码,它们会被放入不同的桶中,导致 HashSet 无法识别它们是重复元素,从而允许重复对象存在,违背了集合的唯一性原则。



















