








在java中,定义泛型抽象方法有两种方式:将泛型参数声明在类级别,或声明在方法级别。如果泛型类型在整个抽象类的所有方法中都需要复用,应使用类级泛型;若仅某个特定方法需要独立的泛型约束,则使用方法级泛型。类级泛型通过 `
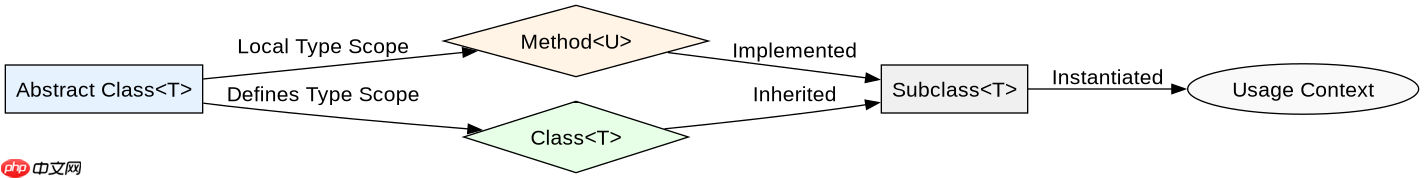
类级泛型抽象方法的实现与继承
当需要在抽象类的多个方法中使用相同的泛型类型时,应在类定义处声明泛型参数。这种模式下,所有非静态成员方法都可以直接使用这个泛型类型。子类在继承该类时,必须明确该泛型的具体类型,或者自身也定义为泛型类以保留灵活性。这种方式确保了类型安全,并在编译期检查类型一致性。
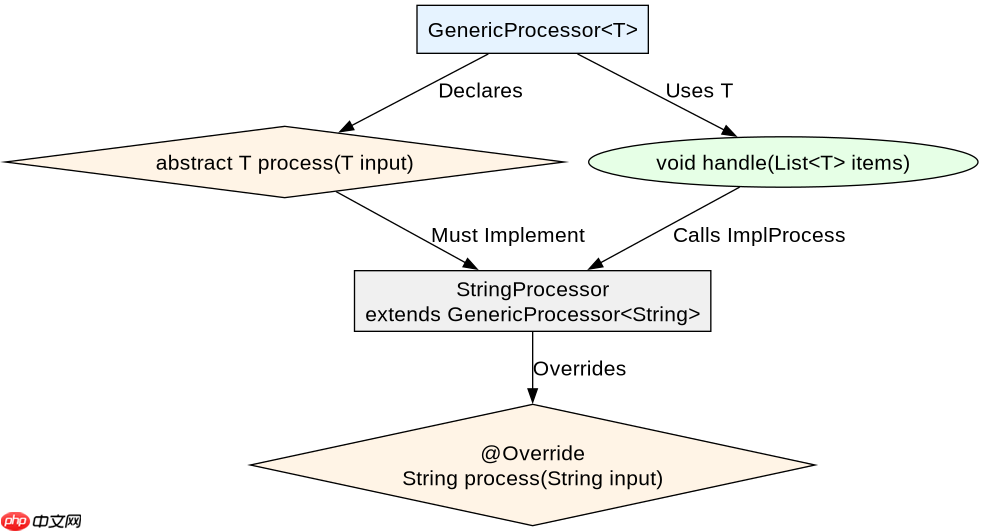
public abstract class GenericProcessor<T> {
    public abstract T process(T input);

    public void handle(List<T> items) {
        for (T item : items) {
            System.out.println(process(item));
        }
    }
}

public class StringProcessor extends GenericProcessor<String> {
    @Override
    public String process(String input) {
        return input.toUpperCase();
    }
}
上述代码展示了类级泛型的标准用法。GenericProcessor 定义了类型为 T 的抽象方法 process。子类 StringProcessor 继承时指定 T 为 String,从而实现了类型安全的处理逻辑。这种设计允许父类提供通用的模板方法(如 handle),而将核心转换逻辑留给子类实现。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
方法级泛型抽象方法的独立约束
如果某个抽象方法需要处理与类本身无关的泛型类型,或者希望每个调用者都能传入不同的泛型类型,应使用方法级泛型。此时,泛型参数 <u></u> 仅在方法签名内有效,不影响类的其他部分。这种方法提供了更高的灵活性,特别适用于工具类或适配器模式中需要转换不同数据类型的场景。
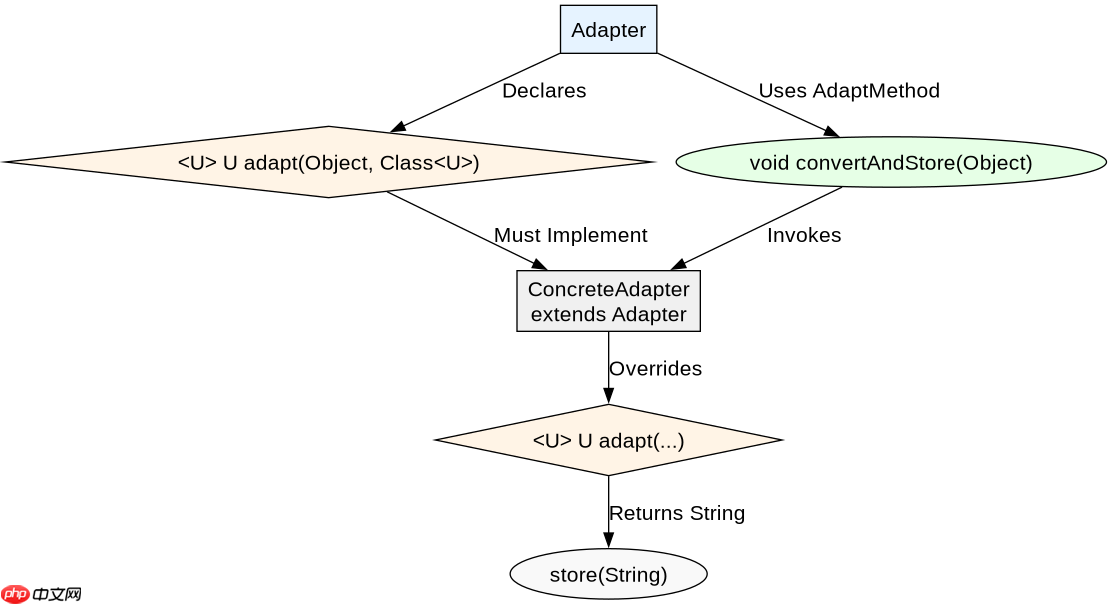
public abstract class Adapter {
    public abstract <U> U adapt(Object source, Class<U> targetType);

    public void convertAndStore(Object data) {
        // 假设有一个存储机制
        store(adapt(data, String.class));
    }

    private void store(String s) {}
}

public class ConcreteAdapter extends Adapter {
    @Override
    public <U> U adapt(Object source, Class<U> targetType) {
        if (targetType == String.class) {
            return targetType.cast(source.toString());
        }
        throw new IllegalArgumentException("Unsupported type");
    }
}
在 Adapter 类中,adapt 方法使用了方法级泛型 U。这使得该方法可以独立于类的任何类型定义,灵活地处理各种输入并返回指定类型的结果。子类 ConcreteAdapter 实现了具体的适配逻辑,利用 Class<u></u> 作为类型令牌来执行运行时类型检查和转换。这种模式避免了类级泛型可能带来的类型膨胀问题。
基于抽象方法返回值的具体类型推断问题
在使用泛型抽象方法时,一个常见的问题是编译器如何推断返回值的类型。对于类级泛型,返回值类型直接对应类定义的 T,子类实现时必须严格匹配。对于方法级泛型,返回值类型 U 由编译器根据方法参数的类型和上下文自动推断。如果无法推断,可能需要显式指定类型参数或使用类型通配符。正确理解这一机制有助于避免类型不匹配错误。



















