








java 中处理中文乱码的核心在于确保字节流与字符流之间使用的编码格式一致,通常推荐直接使用 inputstreamreader 和 outputstreamwriter 并显式指定 utf-8 编码。如果底层是文件操作,应使用 filereader 和 filewriter(注意其依赖平台默认编码,易出错)或更推荐的 files.readalllines 等 nio api。乱码产生的根本原因是解码时指定的字符集与写入时的字符集不匹配,例如用 gbk 读取 utf-8 数据。通过统一使用 standardcharsets.utf_8 可以彻底解决绝大多数乱码问题。
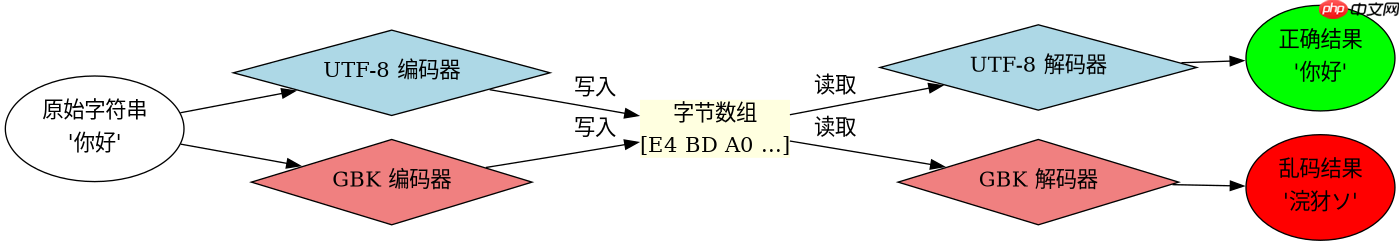
为什么直接转换会导致乱码?
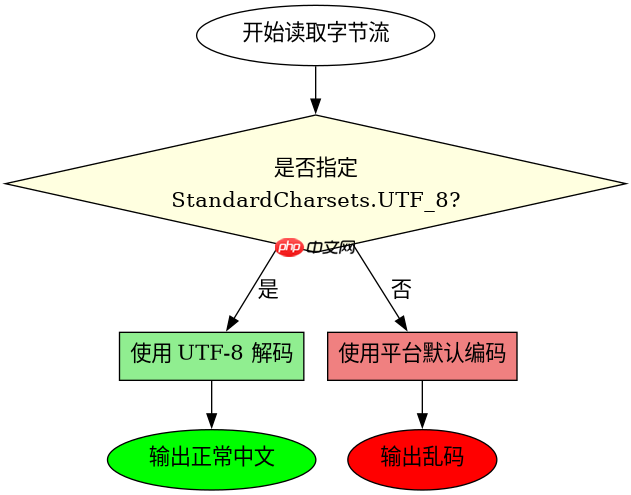
当使用 InputStream 直接读取字节并强制转换为字符串时,如果没有正确指定字符集,JVM 会使用平台默认编码进行解码,这极易导致中文乱码。正确的做法是在包装流时传入明确的编码参数。以下代码展示了错误用法与正确用法的对比,重点在于 new String(bytes, "UTF-8") 中的编码声明。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class EncodingDemo {
    public static void main(String[] args) throws IOException {
        // 模拟一段中文文本
        String original = "你好,世界";

        // 1. 错误示范:使用平台默认编码(可能是GBK),若环境非GBK则乱码
        byte[] bytesDefault = original.getBytes();
        String wrong = new String(bytesDefault);
        System.out.println("默认编码结果: " + wrong);

        // 2. 正确示范:显式指定 UTF-8
        byte[] bytesUtf8 = original.getBytes(StandardCharsets.UTF_8);
        String correct = new String(bytesUtf8, StandardCharsets.UTF_8);
        System.out.println("UTF-8结果: " + correct);

        // 3. 使用 InputStreamReader 处理字节流
        ByteArrayInputStream bais = new ByteArrayInputStream(bytesUtf8);
        InputStreamReader isr = new InputStreamReader(bais, StandardCharsets.UTF_8);
        char[] buffer = new char[1024];
        int len = isr.read(buffer);
        System.out.println("Reader结果: " + new String(buffer, 0, len));
    }
}
运行上述代码,在大多数现代 JVM 环境中,getBytes() 默认可能返回 UTF-8 字节数组,但为了安全起见,必须显式指定。关键在于 InputStreamReader 的构造函数第二个参数必须是 StandardCharsets.UTF_8。如果这里漏掉或写错,就会发生字节到字符的错误映射,产生类似 "ä½ å¥½" 的乱码。图中展示了字节流进入解码器后,因编码不一致导致的分支结果。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
如何高效读写包含中文的文件?
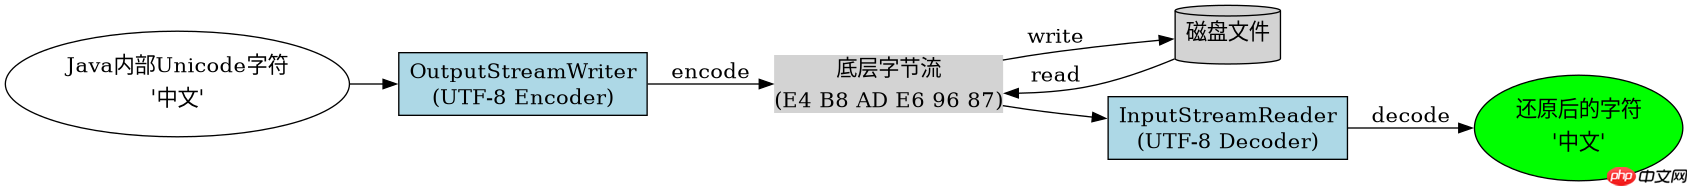
在处理文件 I/O 时,避免手动管理字节缓冲和编码转换的最佳方式是使用 BufferedReader 和 BufferedWriter,并将它们包裹在带有编码指定的 InputStreamReader 和 OutputStreamWriter 之外。这种方式不仅效率高,而且能确保每一行中文都被正确解码和编码。对于简单场景,Java NIO 的 Files 类提供了更简洁的 API。
import java.io.*;
import java.nio.charset.StandardCharsets;
import java.nio.file.*;

public class FileEncodingDemo {
    public static void main(String[] args) throws IOException {
        Path path = Paths.get("test.txt");
        String content = "中文测试内容\n第二行";

        // 方法一:传统 IO 方式,明确指定 UTF-8
        try (OutputStreamWriter osw = new OutputStreamWriter(
                new FileOutputStream(path.toFile()), StandardCharsets.UTF_8)) {
            osw.write(content);
        }

        try (InputStreamReader isr = new InputStreamReader(
                new FileInputStream(path.toFile()), StandardCharsets.UTF_8)) {
            BufferedReader br = new BufferedReader(isr);
            String line;
            while ((line = br.readLine()) != null) {
                System.out.println("读取行: " + line);
            }
        }

        // 方法二:NIO 方式,一行搞定
        Files.writeString(path, content, StandardCharsets.UTF_8);
        String readBack = Files.readString(path, StandardCharsets.UTF_8);
        System.out.println("NIO读取: " + readBack);
    }
}在上述代码中,OutputStreamWriter 负责将 Java 内部的 Unicode 字符编码为指定的字节序列(如 UTF-8)写入底层 FileOutputStream。反之,InputStreamReader 从 FileInputStream 读取字节并按 UTF-8 解码为字符。这种分层结构使得编码逻辑与 I/O 操作解耦。如果使用 FileWriter,它将隐式使用系统默认编码,这在跨平台部署时是危险的。因此,始终推荐使用带编码参数的 OutputStreamWriter 或 NIO 的 Files.writeString。图中描绘了字符流经过编码器转换为字节流的过程,强调了编码器的关键作用。
如何处理混合编码或未知编码的数据源?
当面对来自外部系统、网络请求或旧系统的未知编码数据时,直接假设 UTF-8 可能导致乱码。此时可以使用 BOM(Byte Order Mark)检测或第三方库如 ICU4J 来自动识别编码。例如,UTF-8 BOM 以 \uFEFF 开头,可通过检查前三个字节 EF BB BF 来判断。若未检测到 BOM,可尝试常见编码如 GBK、UTF-8 进行回退测试,观察是否产生合法字符范围。在实际开发中,尽量要求数据提供方统一使用 UTF-8,以避免此类复杂性。


















