








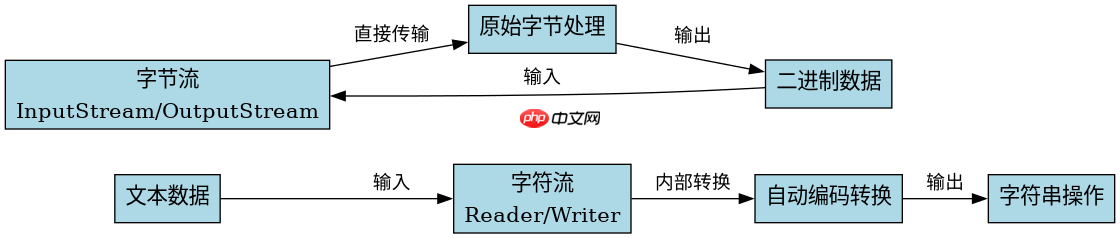
在处理文本数据时应当使用字符流,因为字符流内部集成了编码转换逻辑,能自动将字节按指定字符集解码为字符,避免手动处理乱码。具体做法是优先选用 filereader 和 filewriter 等基于 reader 和 writer 的类,它们默认使用平台编码或允许显式指定编码格式,直接操作字符串而非原始字节序列。
为什么二进制文件不能用字符流处理
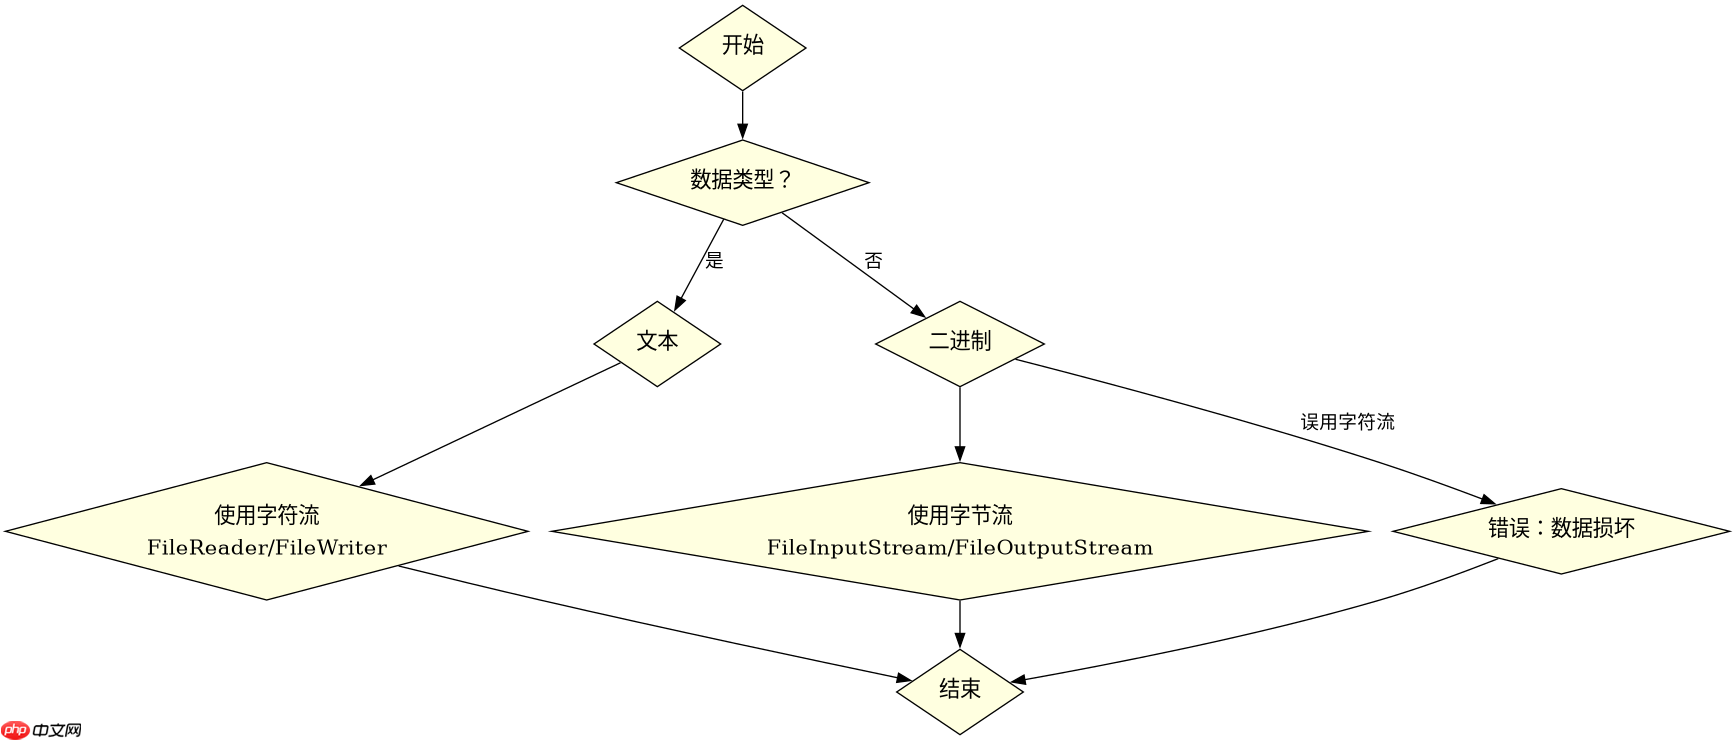
当数据包含非文本内容如图片、音频或可执行文件时,必须使用字节流,因为字符流会强行进行编码转换导致数据损坏。字节流 InputStream 和 OutputStream 直接处理原始字节,不关心数据的语义,适合任何类型的二进制数据传输。
import java.io.*;

public class StreamDemo {
    public static void main(String[] args) throws IOException {
        // 文本处理:使用字符流
        String text = "Hello World";
        try (FileWriter writer = new FileWriter("output.txt")) {
            writer.write(text);
        }

        // 二进制处理:使用字节流
        byte[] data = {0x00, 0xFF, 0x89};
        try (FileOutputStream fos = new FileOutputStream("binary.bin")) {
            fos.write(data);
        }
    }
}
上述代码展示了两种场景的区别。文本写入时 FileWriter 自动将字符串转换为字节,而二进制写入时 FileOutputStream 直接输出原始字节数组。若对二进制数据使用 FileWriter,会导致字节被错误解释为字符编码,造成数据不可逆损坏。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
缓冲流如何提升字符流性能
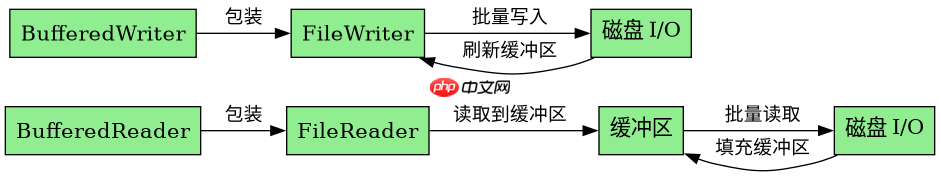
在频繁读写小段文本时,应使用 BufferedReader 和 BufferedWriter 包装基础字符流,以减少系统调用次数。缓冲流在内存中维护一个字节数组缓冲区,批量读取或写入数据,显著提升 I/O 效率。
import java.io.*;

public class BufferedStreamDemo {
    public static void main(String[] args) throws IOException {
        try (BufferedReader reader = new BufferedReader(new FileReader("input.txt"));
             BufferedWriter writer = new BufferedWriter(new FileWriter("output.txt"))) {
            String line;
            while ((line = reader.readLine()) != null) {
                writer.write(line.toUpperCase());
                writer.newLine();
            }
        }
    }
}
该示例中 BufferedReader 逐行读取文本并转换为大写后写入。若不加缓冲,每次 read() 都会触发一次磁盘访问,性能极低。缓冲流通过内部缓冲区合并多次操作,使大文本处理更高效。注意 readLine() 返回的是 String 类型,进一步证明其面向文本的特性。
编码不一致时字符流如何处理
当源文件或目标文件的编码与 JVM 默认编码不一致时,需通过构造函数显式指定 Charset 或使用 InputStreamReader 配合 OutputStreamWriter 来确保正确解码。例如,读取 UTF-8 编码的文件时,应使用 new InputStreamReader(new FileInputStream("file.txt"), StandardCharsets.UTF_8)。
若未指定编码,Java 会使用 System.getProperty("file.encoding") 的值,这在跨平台部署时可能导致乱码。因此,在不确定环境编码的情况下,始终显式声明字符集是最佳实践。此行为在 FileReader 中无法控制,因其无编码参数构造函数,故推荐在需要精确控制时使用底层字节流包装字符流。



















