








在java中,选择字节流还是字符流主要取决于数据源的类型和i/o操作的频率。如果处理的是文本数据且涉及大量频繁的读写操作,使用带缓冲的字符流(如 bufferedreader)通常能显著提升性能;若处理二进制文件或无需编码转换的场景,直接使用字节流(如 fileinputstream)或带缓冲的字节流(如 bufferedinputstream)更为高效。核心原则是:减少系统调用次数,避免不必要的编解码开销。
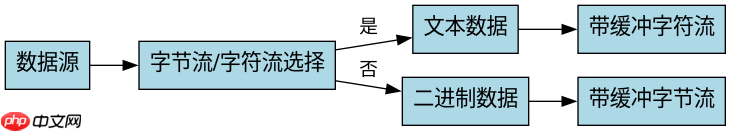
为什么带缓冲的字符流在处理文本时更快
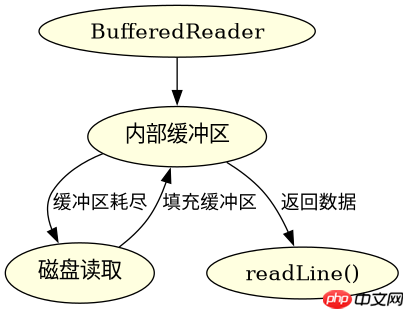
带缓冲的字符流通过内部缓冲区减少了底层I/O调用的次数,从而提升性能。当使用 FileReader 时,每次读取都会触发一次系统调用,而 BufferedReader 会在内存中缓存数据,只有当缓冲区耗尽时才再次访问磁盘。对于文本文件,这种机制能显著降低I/O延迟。
import java.io.*;

public class BufferedCharacterExample {
    public static void main(String[] args) throws IOException {
        // 创建带缓冲的字符输入流
        BufferedReader br = new BufferedReader(new FileReader("input.txt"));
        String line;
        while ((line = br.readLine()) != null) {
            System.out.println(line);
        }
        br.close();
    }
}
上述代码展示了如何使用 BufferedReader 读取文本文件。由于 BufferedReader 内部维护了一个默认大小为8KB的缓冲区,它会将数据从磁盘批量读取到内存中,然后逐行返回。这种方式比直接使用 FileReader 更高效,因为后者每次读取一个字符都会触发一次系统调用。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
字节流在二进制数据处理中的优势
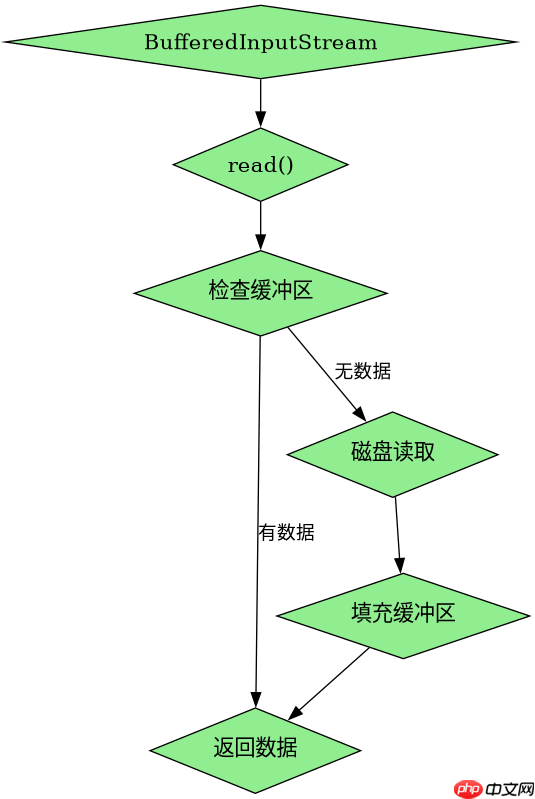
字节流直接处理原始字节,不涉及字符编码转换,因此在处理二进制文件(如图片、音频)时具有天然优势。使用 BufferedInputStream 可以进一步提升读取效率,因为它同样通过缓冲区减少了系统调用次数。与字符流不同,字节流不需要考虑编码问题,适合所有类型的文件。
import java.io.*;

public class BufferedByteExample {
    public static void main(String[] args) throws IOException {
        // 创建带缓冲的字节输入流
        BufferedInputStream bis = new BufferedInputStream(new FileInputStream("image.jpg"));
        int data;
        while ((data = bis.read()) != -1) {
            // 处理字节数据
        }
        bis.close();
    }
}
该示例演示了如何使用 BufferedInputStream 读取二进制文件。由于 BufferedInputStream 内部也使用了缓冲区,它能够批量读取数据并存储在内存中,从而减少了对磁盘的频繁访问。这种方法特别适用于处理非文本数据,避免了字符流可能带来的编码转换开销。
如何根据文件大小调整缓冲区大小
在实际应用中,可以根据文件大小和数据类型动态调整缓冲区大小以优化性能。例如,对于大文件,增大缓冲区可以减少系统调用次数,但会增加内存占用;而对于小文件,较小的缓冲区可能更合适。此外,还可以结合多线程技术,将大文件的读取任务分割成多个部分并行处理,进一步加速I/O操作。




















