








优化 web worker 传输对象序列化开销的核心做法是避免使用 json.stringify/parse,改用结构化克隆算法(structured clone)支持的 transferable objects。具体而言,对于 arraybuffer、sharedarraybuffer、messageport 或 imagebitmap 等可转移对象,应在发送端调用 postmessage 的第二个参数指定 transfer 列表,这会将内存所有权直接移交给 worker,实现零拷贝且无序列化开销。若必须传输普通 javascript 对象,则应尽量减少嵌套层级和属性数量,或将其序列化为紧凑的二进制格式(如使用 messagepack),因为默认的 json 序列化在处理大型复杂对象时会产生显著的 cpu 和时间成本。
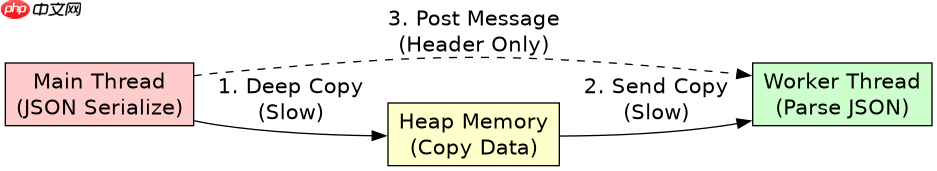
Transferable Objects 如何消除序列化开销
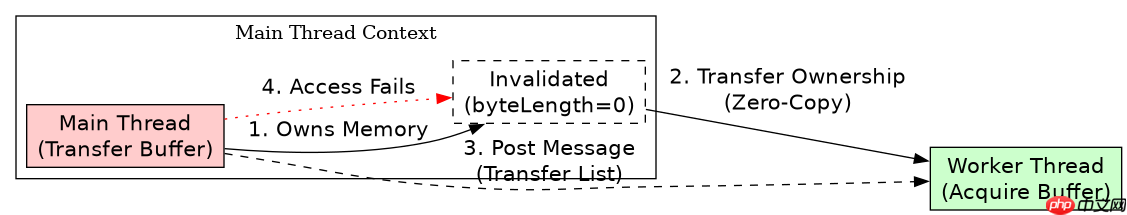
当传输 ArrayBuffer 等支持转移的对象时,浏览器不会执行深拷贝或 JSON 序列化,而是直接将底层内存缓冲区的所有权从主线程传递给 Worker。这意味着数据在内存中只存在一份,传输过程仅涉及指针交换,速度极快且几乎不消耗 CPU 资源。相比之下,如果将 ArrayBuffer 包装在普通对象中并通过 JSON 传输,不仅无法转移,还会触发完整的序列化流程,导致性能大幅下降。
const buffer = new ArrayBuffer(1024 * 1024); // 1MB 数据
// 错误做法:JSON 序列化,慢且占用双倍内存
worker.postMessage({ data: buffer });

// 正确做法:转移所有权,零拷贝
worker.postMessage(buffer, [buffer]);

// 或者在对象中转移特定字段
worker.postMessage(
  { header: 'init', payload: buffer },
  [buffer]
);
console.log('主线程 buffer 已失效:', buffer.byteLength === 0); // true
上述代码展示了两种传输方式的区别。第一种方式将 ArrayBuffer 放入对象中,浏览器会尝试序列化整个对象,包括 buffer 的内容,这会导致巨大的性能开销。第二种方式直接在 postMessage 的第二个参数数组中列出 buffer,浏览器识别后直接转移内存所有权。注意,一旦转移成功,主线程中的 buffer 对象虽然仍存在,但其底层内存已被清空,byteLength 变为 0,此时再访问主线程的 buffer 会导致运行时错误。这种机制特别适用于图像处理、音频处理或大规模数值计算场景,其中数据量通常较大且不需要在主线程保留副本。
立即学习“Java免费学习笔记(深入)”;

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
结构化克隆算法对普通对象的限制与替代方案
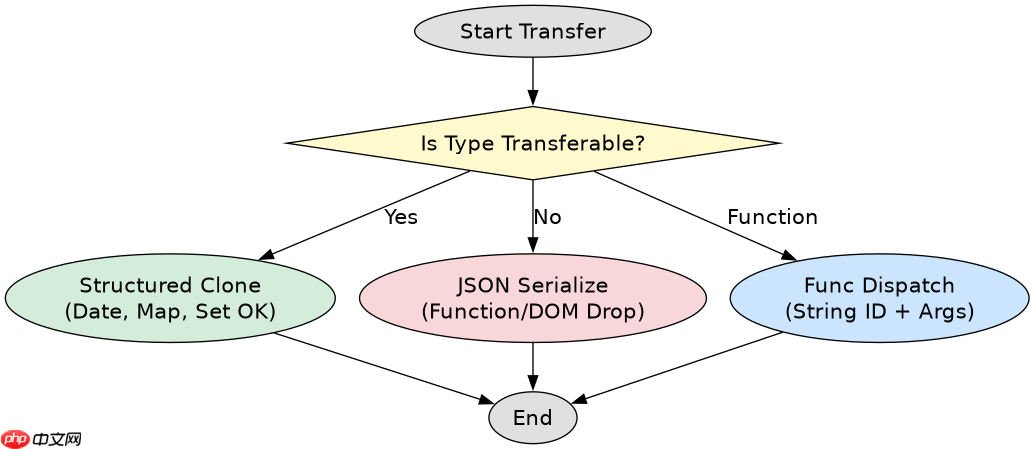
Web Workers 使用的结构化克隆算法(Structured Clone)比 JSON 更强大,它支持 Date、RegExp、Map、Set 等内置对象,但仍不支持函数、DOM 节点和循环引用。对于包含这些不可克隆类型的对象,或者需要频繁传输的小型配置对象,JSON 序列化仍是唯一选择,但可以通过预处理来减少开销。例如,移除不必要的 null 值或未定义字段,或使用轻量级库如 msgpack-lite 进行二进制序列化,可以显著减小数据包体积并加快解析速度。
// 假设有一个包含多种类型的复杂对象
const complexObj = {
  id: 1,
  timestamp: new Date(),
  tags: new Set(['a', 'b']),
  config: { nested: true },
  callback: () => {} // 函数会被忽略
};

// 结构化克隆自动处理 Date 和 Set,但忽略函数
worker.postMessage(complexObj);

// 接收端收到的对象结构
// { id: 1, timestamp: Date(...), tags: Set(...), config: {...} }

// 如果需要传输函数逻辑,需通过字符串标识符分发
const funcMap = {
  'processData': (data) => data.map(x => x * 2)
};
worker.postMessage({ type: 'execute', funcName: 'processData', args: [1, 2, 3] });

// Worker 内部根据 funcName 查找并执行对应函数
self.onmessage = (e) => {
  if (funcMap[e.data.funcName]) {
    const result = funcMap[e.data.funcName](...e.data.args);
    self.postMessage(result);
  }
};
这段代码演示了结构化克隆的实际行为。当传递包含 Date 和 Set 的对象时,Worker 能正确接收并还原这些类型,无需手动转换。然而,函数无法被序列化,因此必须采用策略模式,通过传递函数名和参数,让 Worker 内部映射表执行相应逻辑。这种方法避免了传输庞大代码块的开销,同时保持了灵活性。对于纯数据对象,建议在使用前清理无用属性,例如使用 Object.keys(obj).filter(k => obj[k] !== undefined && obj[k] !== null) 生成精简键列表,再构建新对象传输,从而减少序列化时的遍历次数和数据大小。
基于大数组缓冲区的内存泄漏风险与验证
在使用 Transferable Objects 时,一个常见的陷阱是误以为转移后主线程对象仍可使用,导致潜在的内存管理混乱或逻辑错误。由于转移后原对象内存被清空,任何后续对该对象的读写操作都会失败或产生未定义行为。开发者必须确保在主线程完成所有必要的数据读取或备份后,再进行转移操作。此外,对于 SharedArrayBuffer,虽然可以实现共享内存而无需显式转移,但需要处理同步原语(如 Atomics)以避免竞态条件,这在某些场景下可能比简单的消息传递更复杂。
const sharedBuffer = new SharedArrayBuffer(1024);
const sharedView = new Int32Array(sharedBuffer);

// 主线程写入数据
sharedView[0] = 42;

// 启动 Worker 并共享缓冲区
const worker = new Worker('worker.js');
worker.postMessage(sharedBuffer, [sharedBuffer]);

// 关键:主线程不能再依赖 sharedView[0] 的值保持为 42
// 因为 Worker 可能随时修改它,且没有锁保护
// 正确的做法是使用 Atomics.wait/notify 进行同步
Atomics.notify(sharedView, 0);

// Worker 端示例
self.onmessage = (e) => {
  const buf = e.data;
  const view = new Int32Array(buf);
  view[0] = 100; // 修改共享内存
  Atomics.notify(view, 0); // 通知主线程
};
此代码片段展示了 SharedArrayBuffer 的使用场景。与 Transferable Objects 不同,SharedArrayBuffer 允许主线程和 Worker 同时访问同一块内存,无需转移所有权。但这要求开发者手动处理并发问题,例如使用 Atomics 原子操作来保证数据一致性。在主线程中,一旦缓冲区被传递给 Worker,主线程就不能再假设其内容不变,必须通过同步机制协调读写。这种模式适用于高性能计算场景,如物理模拟或实时数据处理,其中低延迟通信至关重要。然而,对于大多数应用,简单的 postMessage 配合 Transferable Objects 仍然是更安全、更易维护的选择,因为它避免了共享状态带来的复杂性。


















