








区分字节流与字符流的核心在于处理的数据类型:纯二进制数据(如图片、音频)必须使用字节流,而文本数据应使用字符流以避免乱码。具体做法是,在读取或写入文本时,指定正确的编码格式(如utf-8),并优先使用`inputstreamreader`和`outputstreamwriter`作为桥梁,将字节流转换为字符流。若直接使用字节流处理文本且未正确指定编码,极易因平台默认编码不一致导致乱码。
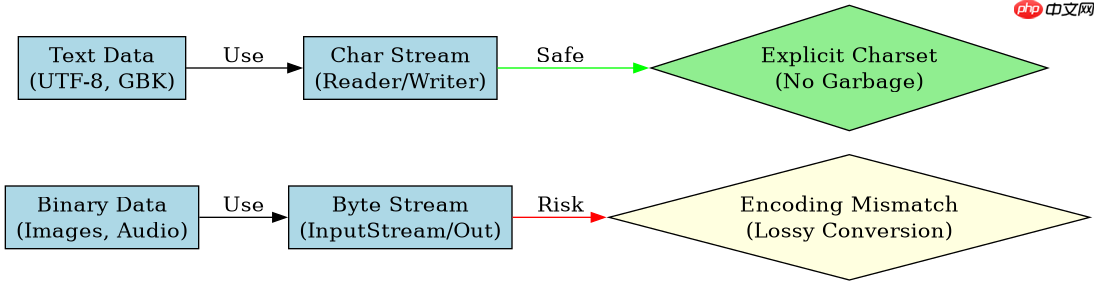
为什么直接读字节流会乱码
直接使用`FileInputStream`读取文本文件会产生乱码,因为字节流按单字节传输,无法识别多字节字符(如UTF-8中的中文占3字节)。当系统默认编码(如Windows的GBK)与文件实际编码(如UTF-8)不匹配时,字节序列会被错误解析为无效字符。例如,一个UTF-8编码的“中”字由三个字节组成,若用GBK解码,这三个字节可能被解释为两个不同的汉字或乱码符号。


FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import java.io.*;

public class ByteStreamDemo {
    public static void main(String[] args) throws IOException {
        // 假设有一个UTF-8编码的文件
        String filePath = "test.txt";

        // 错误做法:直接用字节流读取,依赖系统默认编码
        try (FileInputStream fis = new FileInputStream(filePath)) {
            byte[] bytes = fis.readAllBytes();
            // 这里可能产生乱码,如果系统默认不是UTF-8
            String wrongText = new String(bytes);
            System.out.println("Wrong: " + wrongText);
        }

        // 正确做法:显式指定UTF-8编码
        try (FileInputStream fis = new FileInputStream(filePath)) {
            byte[] bytes = fis.readAllBytes();
            String correctText = new String(bytes, "UTF-8");
            System.out.println("Correct: " + correctText);
        }
    }
}
运行上述代码,若`test.txt`包含中文“你好”,且系统默认编码为GBK,则第一种方式输出乱码,第二种方式输出“你好”。关键在于`new String(byte[], charset)`中显式指定了编码。
立即学习“Java免费学习笔记(深入)”;
如何正确使用字符流包装字节流
避免乱码的最佳实践是使用`InputStreamReader`和`OutputStreamWriter`包装字节流,并明确指定编码。这些类充当“翻译器”,将字节序列根据指定编码转换为字符序列。例如,`new InputStreamReader(new FileInputStream(file),



















