








Java 基本数据类型怎么用JSON序列化避免精度问题
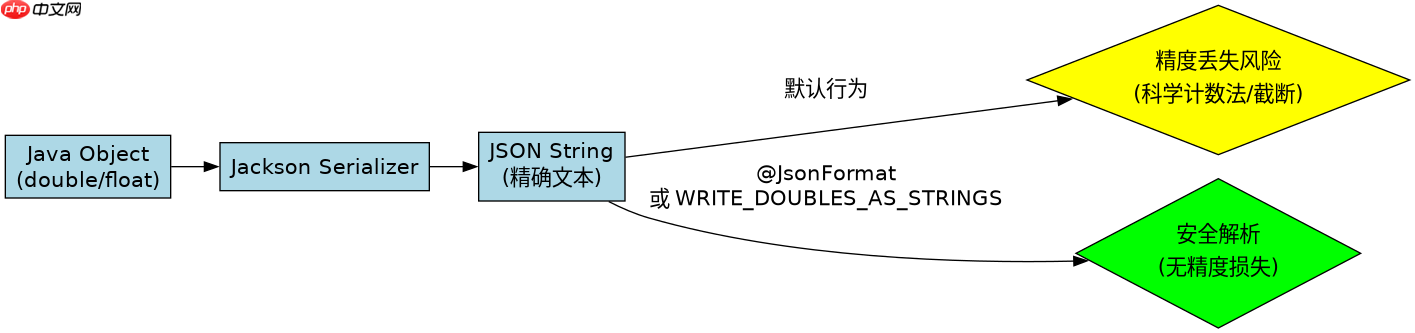
在 java 中将基本数据类型(如 double、float)序列化为 json 时,默认行为可能会丢失精度或产生科学计数法表示。要避免这个问题,最直接且通用的做法是使用 jackson 库的 @jsonformat 注解配合模式字符串,或者配置全局的 objectmapper 将浮点数强制序列化为字符串。这样可以将数值转换为精确的文本表示,从而在传输和解析过程中保留原始精度。
使用 @JsonFormat 注解处理单个字段
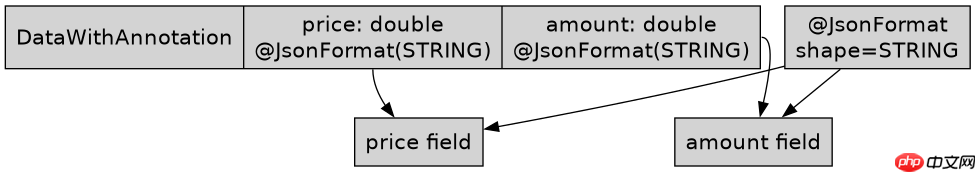
针对特定的浮点数字段,可以在 Getter 方法或字段上添加 @JsonFormat 注解,并设置 shape = JsonFormat.Shape.STRING。这告诉 Jackson 在序列化该特定字段时,不要使用默认的数值格式,而是将其转换为字符串。这种方法适用于只需要对部分高精度字段进行特殊处理的场景。
import com.fasterxml.jackson.annotation.JsonFormat;
import com.fasterxml.jackson.databind.ObjectMapper;

public class PrecisionExample {
    public static void main(String[] args) throws Exception {
        ObjectMapper mapper = new ObjectMapper();

        // 创建包含双精度的对象
        DataWithAnnotation data = new DataWithAnnotation();
        data.price = 19.99;
        data.amount = 0.1 + 0.2; // 典型精度丢失示例

        // 序列化
        String json = mapper.writeValueAsString(data);
        System.out.println(json);

        // 反序列化回对象
        DataWithAnnotation parsed = mapper.readValue(json, DataWithAnnotation.class);
        System.out.println("Parsed amount: " + parsed.amount);
    }
}

class DataWithAnnotation {
    @JsonFormat(shape = JsonFormat.Shape.STRING)
    public double price;

    @JsonFormat(shape = JsonFormat.Shape.STRING)
    public double amount;
}
全局配置 ObjectMapper 统一处理
如果项目中所有浮点数都需要以字符串形式序列化,可以通过配置 ObjectMapper 的全局属性来实现。使用 mapper.enable(SerializationFeature.WRITE_DOUBLES_AS_STRINGS) 可以强制将所有 double 类型序列化为 JSON 字符串。这种方式适合微服务接口定义中明确约定数值以字符串传输的情况,避免了在每个字段上重复添加注解。

KeystoneJS 是一个功能强大的开源无头 CMS,适用于 Node.js,它根据您的模式定义自动生成 GraphQL API 和基于 React 的管理界面。由 Thinkmill 构建,支持 PostgreSQL 和 SQLite、自定义访问控制、钩子、虚拟字段和基于文档的富文本编辑。
立即学习“Java免费学习笔记(深入)”;

import com.fasterxml.jackson.databind.ObjectMapper;
import com.fasterxml.jackson.databind.SerializationFeature;

public class GlobalConfigExample {
    public static void main(String[] args) throws Exception {
        ObjectMapper mapper = new ObjectMapper();
        // 全局配置:所有 double 序列化为字符串
        mapper.enable(SerializationFeature.WRITE_DOUBLES_AS_STRINGS);

        DataGlobal data = new DataGlobal();
        data.value = 123456789.123456789;

        String json = mapper.writeValueAsString(data);
        System.out.println(json); // 输出: {"value":"123456789.123456789"}
    }
}

class DataGlobal {
    public double value;
}
基于程序中某个输入、条件或结果的具体问题
当使用 WRITE_DOUBLES_AS_STRINGS 全局配置时,如果反序列化目标类中的字段是 double 类型,Jackson 会自动将 JSON 中的字符串解析为 double。然而,这种解析过程本身无法恢复已经丢失的精度(例如 0.1+0.2 的结果)。如果需要在代码中严格保持精度,建议在模型中使用 BigDecimal 类型代替 double,并结合 @JsonFormat 或全局配置使用。对于 BigDecimal,Jackson 默认会将其序列化为数字而非字符串,除非特别配置。若希望 BigDecimal 也作为字符串传输以避免任何潜在的解析歧义,需额外配置 mapper.configure(MapperFeature.ACCEPT_CASE_INSENSITIVE_PROPERTIES, false) 或使用自定义序列化器。



















