








oracle主库未归档日志丢失后备库无法通过常规介质恢复手段挽回数据,因为缺失的redo log意味着从最后检查点到故障点之间的所有事务变更已永久不可用。最大程度挽回数据的唯一可行方案是立即停止备库应用,将其提升为独立的主库以保留现有数据一致性,随后基于该新主库重新构建物理备库或逻辑备库,从而将损失控制在最后一次成功同步的时间点。

如何确认当前备库的数据一致性状态
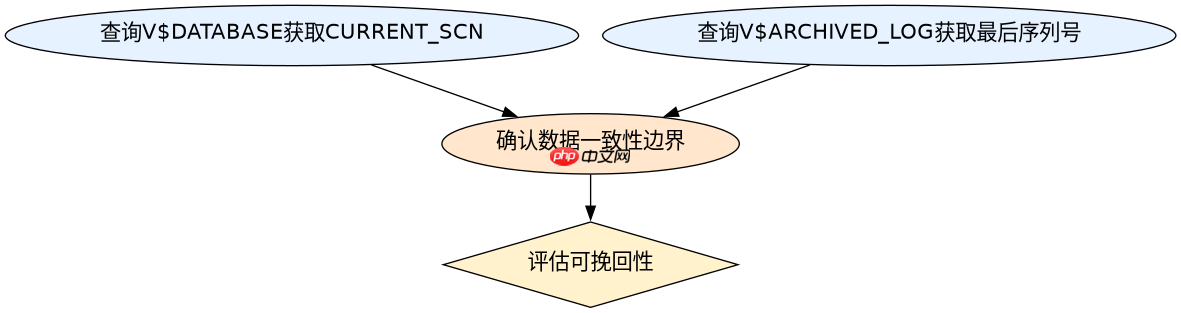
在决定挽救策略前,必须明确备库当前所处的SCN(系统改变号)位置,这决定了数据丢失的范围。可以通过查询视图 V$DATABASE 和 V$ARCHIVED_LOG 来获取关键信息。如果备库处于实时应用模式,其数据文件SCN与主库一致;若存在延迟或中断,则需查看 V$MANAGED_STANDBY 中最后一个应用的日志序列号。确认这些指标后,才能判断哪些事务可能已经写入磁盘但未被归档,或者哪些事务完全丢失。
-- 检查备库当前的SCN和应用状态
SELECT CURRENT_SCN, DATABASE_ROLE, OPEN_MODE
FROM V$DATABASE;

-- 查看最后应用的归档日志序列号
SELECT SEQUENCE#, APPLIED, COMPLETION_TIME
FROM V$ARCHIVED_LOG
ORDER BY SEQUENCE# DESC;
执行上述SQL后,记录返回的 CURRENT_SCN 值。这个数值代表了备库数据的一致性边界。任何大于此SCN的事务在主库上虽然可能已提交,但在备库上并不存在,因此这部分数据在后续重建过程中将无法自动同步回来,除非有额外的备份支持。
如何将备库提升为独立主库并重建环境
由于主库的未归档日志丢失,传统的 SWITCHOVER 操作会失败,必须使用 FAILOVER 命令强制将备库提升为主库。这一步骤是不可逆的,且会导致原主库彻底失效。提升完成后,需要基于新的主库创建一个新的备库实例,以恢复高可用架构。具体做法包括在新环境中配置 STANDBY_FILE_MANAGEMENT,并重新设置 FAL_SERVER 和 FAL_CLIENT 参数以确保日志传输正常。

-- 在备库上执行强制切换
ALTER DATABASE RECOVER MANAGED STANDBY DATABASE FINISH FORCE;
ALTER DATABASE COMMIT TO SWITCHOVER TO PRIMARY WITH SESSION SHUTDOWN;

-- 重启数据库以确保持久化角色变更
SHUTDOWN IMMEDIATE;
STARTUP MOUNT;
ALTER DATABASE OPEN RESETLOGS;
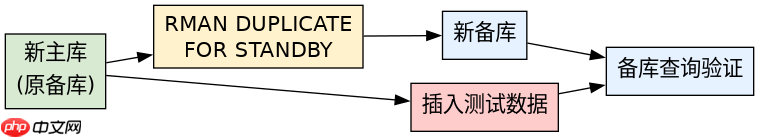
完成切换后,原备库已成为新的主库。此时,你需要在一台新的服务器或同一服务器的不同实例上搭建一个新的备库。使用 RMAN DUPLICATE TARGET DATABASE FOR STANDBY 命令可以从新主库克隆出一个全新的备库。这个过程会复制当前的数据文件和控制文件,确保新备库与新主库在初始状态下完全一致。此后,所有的增量备份和日志传输都将基于这个新的时间点开始,之前的未归档日志丢失问题不再影响新架构的运行。
基于特定输入条件验证新备库的同步效果
在新备库构建完成后,必须验证其是否能正确接收并应用来自新主库的日志。可以通过在新主库上创建一个测试表并插入少量数据进行模拟。例如,创建一个名为 TEST_SYNC 的表,插入一行包含时间戳的记录,然后观察新备库是否能在几秒内看到这条数据。这种验证方式能够直观地展示日志链路是否畅通,以及 LOG_ARCHIVE_DEST_STATE 等参数配置是否正确。
-- 在新主库上执行测试
CREATE TABLE TEST_SYNC (ID NUMBER, TIMESTAMP_VAL DATE);
INSERT INTO TEST_SYNC VALUES (1, SYSDATE);
COMMIT;
在备库上查询 TEST_SYNC 表,如果能看到刚才插入的数据,说明同步机制工作正常。如果数据未出现,需检查 V$DATAGUARD_STATUS 中的错误信息,常见原因包括网络不通、权限不足或归档路径配置错误。通过这种具体的输入输出验证,可以确保新建立的容灾体系具备实际可用性,避免因配置疏忽导致二次故障。



















