








使用 percent_rank() 窗口函数可以计算当前行在分区内的相对排位,公式为 (rank - 1) / (total_rows - 1)。它返回 0 到 1 之间的浮点数,0 表示最小值,1 表示最大值。通过指定 order by 子句确定排序方向,并用 over 子句定义分区范围。

PERCENT_RANK() 的基本语法与排序逻辑是什么?
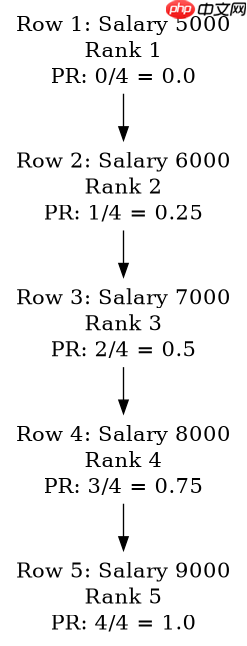
该函数的核心在于处理排序后的行号。它不关心具体的数值大小,只关心行的相对位置。当存在并列数据时,PERCENT_RANK 会跳过相应的排名间隙,确保最大值的百分比始终为 1。基本语法是在 SELECT 列表中调用函数,并在 OVER 中指定 ORDER BY 列。
SELECT
    employee_name,
    salary,
    PERCENT_RANK() OVER (ORDER BY salary ASC) AS percent_rank_asc
FROM
    employees;
上述查询按薪资升序排列。如果所有薪资都不同,最低薪资的行返回 0.0,最高薪资的行返回 1.0。中间行的值取决于其前后行的数量差。例如,如果有 5 行数据,第 3 行的排名是 3(从 1 开始计数),则结果为 (3-1)/(5-1) = 0.5。
如何在分组内计算 PERCENT_RANK?
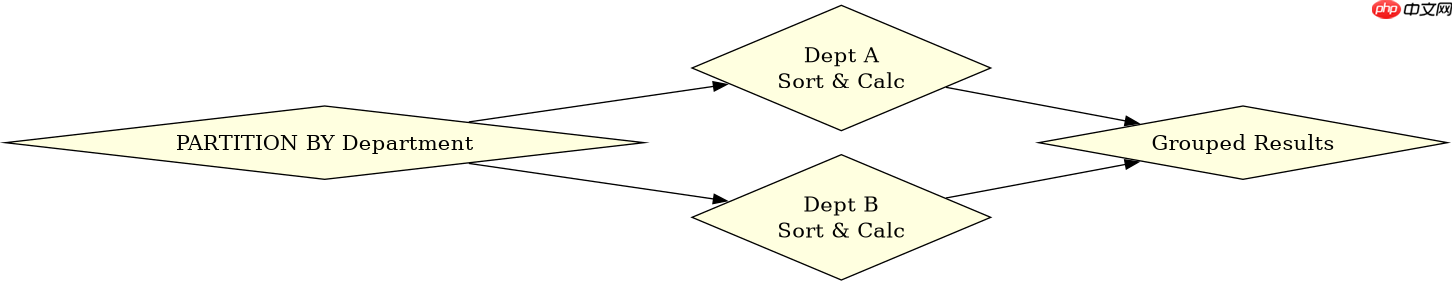
在实际业务中,通常需要在每个部门或类别内部比较员工的绩效。通过在 OVER 子句中添加 PARTITION BY,可以将数据划分为独立的组,并在每个组内独立计算排位。这确保了不同组之间的数据不会相互影响排位的计算。
SELECT
    department,
    employee_name,
    salary,
    PERCENT_RANK() OVER (
        PARTITION BY department
        ORDER BY salary DESC
    ) AS dept_percent_rank
FROM
    employees;
此查询将员工按部门分组,并在每个部门内按薪资降序计算排位。这意味着每个部门的最高薪资员工在该部门内的 PERCENT_RANK 为 0.0(因为降序时最大值排第一,rank=1, (1-1)/N=0),而最低薪资员工为 1.0。这种分组计算方式能更公平地反映个体在其所属群体中的相对水平。
当存在相同薪资时 PERCENT_RANK 如何变化?
如果多名员工拥有相同的薪资,PERCENT_RANK 的处理方式与 RANK() 类似,但计算结果会有所不同。相同薪资的行会被赋予相同的排名(即该行之前所有行数加 1),并且后续的排名会跳过相应的数量。这导致相同值的行具有相同的百分比排位,且下一个不同值的排位会相应后移,从而保持最大值为 1 的特性。


















