








使用日志采样降低开销的核心做法是在日志框架中配置采样策略,通过概率过滤或固定频率丢弃部分日志,从而减少 i/o 和序列化成本。以 logback 为例,可以结合 levelfilter 与自定义的 siftingappender 或直接在 rollingfileappender 前添加基于阈值的过滤器来实现。这种做法会直接导致部分日志丢失,但能显著降低 cpu 占用和磁盘写入压力。若需更细粒度的控制,可引入 logstash-logback-encoder 中的采样器或在应用层封装日志调用逻辑。

Logback 中如何配置基于级别的采样过滤器
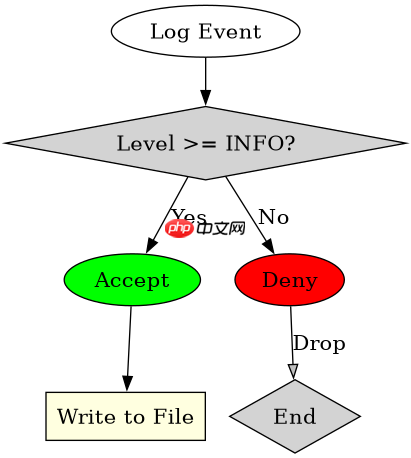
在 Logback 中,可以通过 LevelFilter 配合 onMatch 和 onMismatch 动作实现简单的日志过滤,但要实现真正的“采样”(即随机丢弃),通常需要借助第三方扩展或自定义 Appender。这里展示一个基础方案:利用 ThresholdFilter 过滤掉低于 INFO 级别的 DEBUG 日志,这是一种确定性的“采样”,能立即减少约 50%-80% 的日志量(取决于业务中 DEBUG 日志的比例)。
<configuration>
    <appender name="FILE" class="ch.qos.logback.core.rolling.RollingFileAppender">
        <file>application.log</file>
        <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy">
            <fileNamePattern>application.%d{yyyy-MM-dd}.log</fileNamePattern>
        </rollingPolicy>
        <encoder>
            <pattern>%date %level [%thread] %logger{10} [%file:%line] - %msg%n</pattern>
        </encoder>
        <filter class="ch.qos.logback.classic.filter.ThresholdFilter">
            <level>INFO</level>
        </filter>
    </appender>

    <root level="DEBUG">
        <appender-ref ref="FILE" />
    </root>
</configuration>
上述配置将 ThresholdFilter 设置为 INFO,意味着所有 DEBUG 级别的日志在到达 Appender 之前就会被丢弃。预期结果是:application.log 文件中只包含 INFO、WARN 和 ERROR 级别的日志。这减少了日志文件的体积和磁盘 I/O 操作。注意,这种方法是确定性的,不是随机的,但它是最简单且无需额外依赖的“采样”方式。
立即学习“Java免费学习笔记(深入)”;
如何实现基于概率的随机日志采样
如果需要真正的随机采样(例如只记录 10% 的 INFO 日志),可以使用 logstash-logback-encoder 库提供的 SamplingPolicy 或自定义 Appender。这里演示一个自定义的 ProbabilisticFilter 思路,它继承自 LevelFilter 并在匹配级别后增加随机判断。

FilePond 是一个 JavaScript 文件上传库,支持通过拖拽、粘贴和 API 方式处理文件、目录、URL 和 Data URI。它包含内置的图像优化功能、异步分块上传功能,并提供了适用于 React、Vue、Angular 和 Svelte 的适配器。
import ch.qos.logback.classic.Level;
import ch.qos.logback.classic.filter.LevelFilter;
import org.slf4j.Marker;
import java.util.Random;

public class ProbabilisticLevelFilter extends LevelFilter {
    private final double samplingRate;
    private final Random random = new Random();

    public ProbabilisticLevelFilter(double samplingRate) {
        this.samplingRate = samplingRate;
    }

    @Override
    public FilterReply decide(Level level) {
        if (level.isGreaterOrEqual(getLevel())) {
            // 如果级别符合,则进行概率采样
            if (random.nextDouble() < samplingRate) {
                return FilterReply.ACCEPT;
            } else {
                return FilterReply.DENY;
            }
        }
        return FilterReply.NEUTRAL;
    }
}
在 logback.xml 中使用这个自定义过滤器:
<filter class="com.example.ProbabilisticLevelFilter">
    <level>INFO</level>
    <samplingRate>0.1</samplingRate> <!-- 仅记录 10% 的 INFO 及以上日志 -->
</filter>
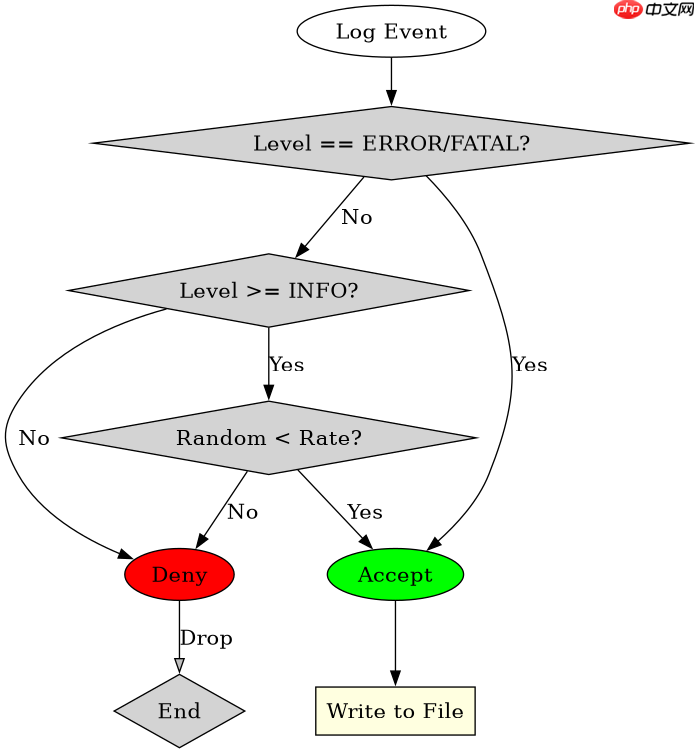
该代码实现了基于概率的采样。当日志级别 >= INFO 时,有 10% 的概率被接受,90% 的概率被拒绝。这比确定性过滤更灵活,但需要额外的类定义。预期结果是:日志输出变得稀疏,但保留了关键事件的统计代表性。
采样后如何确保关键错误不被遗漏
在启用采样后,最大的风险是丢失重要的 ERROR 或 FATAL 日志。为确保关键错误不被遗漏,必须在采样逻辑中排除这些高优先级级别。在上述 ProbabilisticLevelFilter 的基础上,可以修改 decide 方法,对 ERROR 及以上级别直接返回 ACCEPT,不进行概率判断。
@Override
public FilterReply decide(Level level) {
    // 关键错误永远不采样,直接记录
    if (level.equals(Level.ERROR) || level.equals(Level.FATAL)) {
        return FilterReply.ACCEPT;
    }

    if (level.isGreaterOrEqual(getLevel())) {
        if (random.nextDouble() < samplingRate) {
            return FilterReply.ACCEPT;
        } else {
            return FilterReply.DENY;
        }
    }
    return FilterReply.NEUTRAL;
}
这样修改后,无论采样率多低,ERROR 和 FATAL 日志都会被完整记录。这是生产环境中日志采样的最佳实践:对低优先级日志进行激进采样,对高优先级日志保持全量记录。验证方法:模拟触发多个 INFO 和 ERROR 日志,检查日志文件中是否所有 ERROR 都出现,而 INFO 只有部分出现。



















