








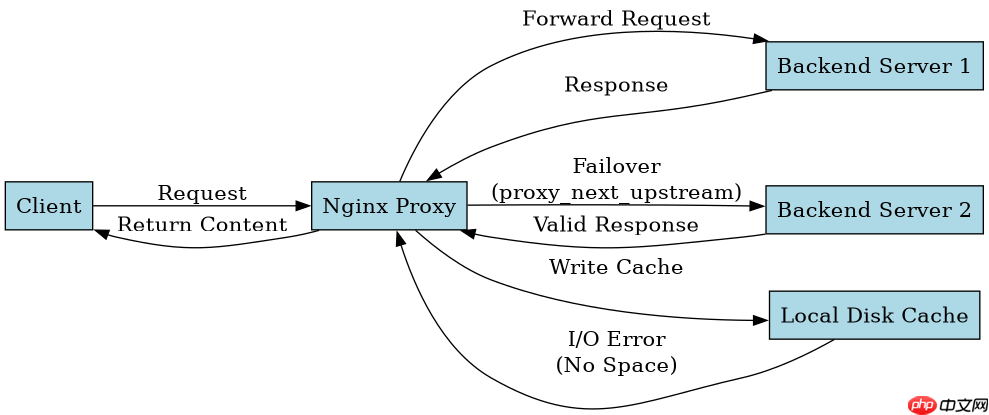
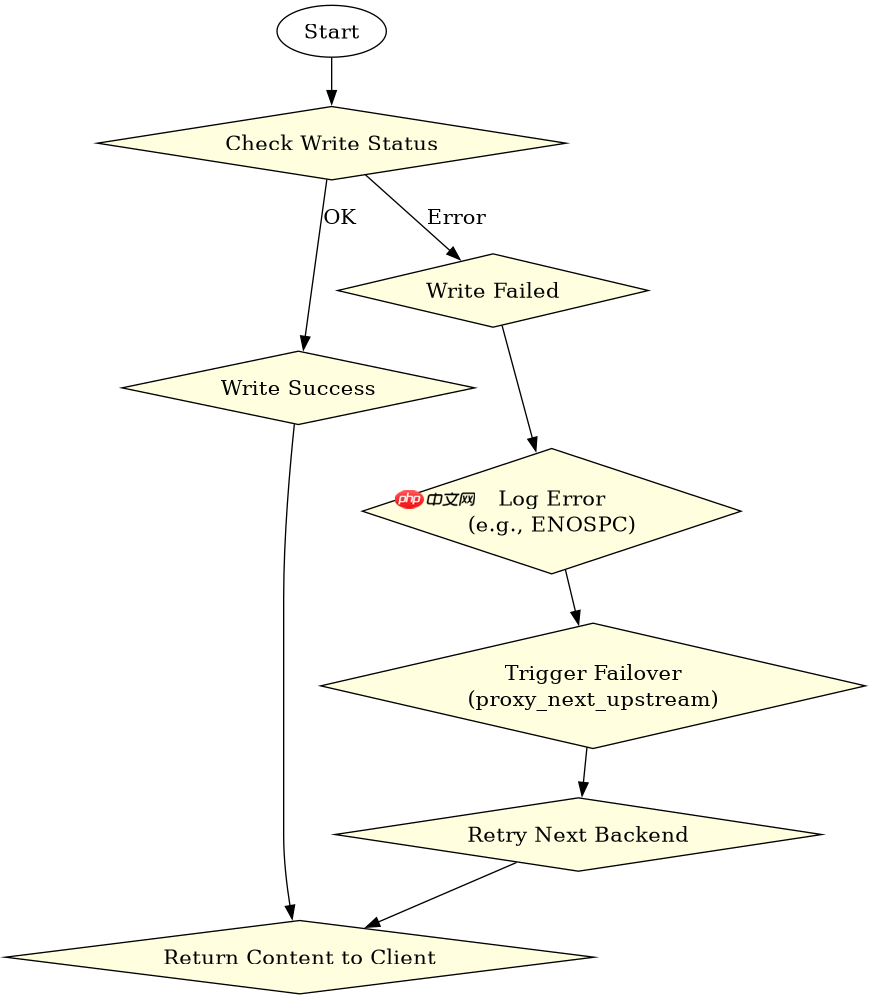
配置 nginx proxy_cache 缓存写磁盘失败处理,核心在于利用 proxy_next_upstream 指令将写入错误视为后端故障,从而触发故障转移机制。具体做法是在 location 块中设置 proxy_next_upstream error timeout invalid_header http_500 http_502 http_503 http_504;,并配合 proxy_cache_background_update on; 实现后台刷新。当 nginx 尝试将响应写入磁盘缓存时若发生 i/o 错误(如磁盘满、权限不足),nginx 会记录日志并将该请求转发给下一个上游服务器,确保用户端获得有效响应而非 502/504 错误。
如何区分缓存写入失败与网络超时
在排查缓存问题时,需明确区分磁盘 I/O 错误与网络连接问题。proxy_next_upstream 中的 error 参数涵盖了多种底层错误,包括连接重置、读取超时以及文件写入失败。通过检查 Nginx 的 error.log,可以定位具体的失败原因。例如,若日志中出现 upstream prematurely closed connection,通常指向网络或后端问题;而 open() "/path/to/cache" failed (28: No space left on device) 则明确指向磁盘空间不足导致的写入失败。正确配置 proxy_next_upstream 能确保这两类错误都能触发备用策略,但处理方式略有不同:网络超时可能重试同一节点,而磁盘错误通常强制切换至其他健康节点。
server {
    listen 80;
    server_name example.com;

    # 定义缓存路径和参数
    proxy_cache_path /var/cache/nginx levels=1:2 keys_zone=my_cache:10m max_size=10g inactive=60m use_temp_path=off;

    location / {
        proxy_pass http://backend_servers;
        proxy_cache my_cache;

        # 关键配置:将写入错误视为上游错误,触发故障转移
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503 http_504;

        # 允许后台更新,避免冷启动时所有请求同时打向后端
        proxy_cache_background_update on;

        # 设置缓存过期时间
        proxy_cache_valid 200 302 10m;
        proxy_cache_valid 404 1m;
    }
}
上述配置中,use_temp_path=off 是一个重要优化点。默认情况下,Nginx 先将内容写入临时文件,再重命名到最终缓存位置。如果临时目录和目标目录不在同一文件系统,或者磁盘空间紧张,这一步骤容易失败。关闭临时路径后,Nginx 直接写入最终缓存文件,减少了系统调用和潜在的文件系统操作失败风险。结合 proxy_next_upstream error,一旦直接写入失败,Nginx 会立即将该请求视为失败,并尝试从下一个上游服务器获取内容,同时将新的响应重新写入缓存(如果可用)。
如何处理缓存目录权限与空间监控
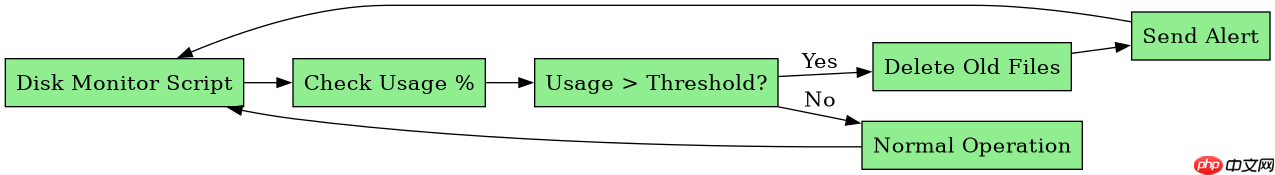
缓存写入失败的常见原因还包括权限问题和磁盘空间耗尽。Nginx worker 进程通常以非 root 用户运行(如 nginx 或 www-data),因此必须确保缓存目录及其父目录对该用户具有读写权限。可以使用 chown -R nginx:nginx /var/cache/nginx 命令修正权限。此外,定期监控磁盘空间至关重要。当磁盘使用率达到阈值时,应自动清理旧缓存文件或触发告警。可以通过 cron 任务或监控系统定期检查 df -h 输出,并结合 proxy_cache_path 中的 max_size 参数限制缓存总大小。当达到最大容量时,Nginx 会根据 LRU 算法自动删除最久未使用的缓存项,但如果磁盘完全填满,仍可能导致写入失败,此时 proxy_next_upstream 的故障转移机制将成为最后一道防线。

# 监控脚本示例:检查缓存目录空间并清理
#!/bin/bash
CACHE_DIR="/var/cache/nginx"
THRESHOLD=90

# 获取磁盘使用率
USAGE=$(df -h $CACHE_DIR | awk 'NR==2 {print $5}' | sed 's/%//')

if [ "$USAGE" -gt "$THRESHOLD" ]; then
    echo "Cache directory usage is high: ${USAGE}%"
    # 清理超过7天的缓存文件
    find $CACHE_DIR -type f -mtime +7 -delete
    # 发送告警通知
    mail -s "Nginx Cache Cleanup Alert" admin@example.com << EOF
Disk usage for $CACHE_DIR is at ${USAGE}%. Old files have been cleaned.
EOF
fi
除了自动化清理,还可以利用 Nginx 的 proxy_cache_key 和 proxy_cache_lock 来优化缓存命中率并减少重复写入。虽然这些不直接解决写入失败问题,但它们能降低缓存系统的整体负载,间接减少因高并发导致的 I/O 瓶颈。在实际生产中,建议将缓存目录放置在独立的磁盘分区上,以避免业务流量影响缓存性能。同时,启用 proxy_cache_use_stale 可以在缓存更新期间提供过期的 stale 内容,进一步提升用户体验,尤其是在缓存写入暂时不可用的情况下。
基于磁盘满场景的具体故障转移行为
当磁盘空间完全耗尽时,Nginx 的缓存写入行为会表现出特定的故障转移特征。假设我们有一个典型的 Web 应用,后端有多个服务器节点。当第一个节点尝试写入缓存时,由于磁盘已满,操作系统返回 ENOSPC 错误。Nginx 捕获此错误后,根据 proxy_next_upstream error 的配置,会将该请求标记为失败,并立即向第二个上游服务器发起请求。如果第二个服务器成功响应,Nginx 会将其内容返回给用户,并尝试写入本地缓存。如果第二个服务器的缓存也处于类似状态,Nginx 会继续尝试后续节点,直到找到一个能够成功处理请求且可写入缓存的节点,或者所有节点都失败为止。这种机制确保了即使在部分基础设施故障的情况下,服务依然可用。
为了验证这一行为,可以模拟磁盘满环境。在测试环境中,使用 dd 命令创建一个固定大小的文件并挂载到缓存目录,然后填充该文件直至磁盘满。随后,向 Nginx 发送大量请求,观察 error.log 中是否出现 No space left on device 错误,并检查客户端是否收到了来自备用服务器的响应。通过这种方式,可以确认 proxy_next_upstream 是否正确触发了故障转移,以及缓存失效后的回退机制是否按预期工作。这种测试有助于发现潜在的配置缺陷,并在生产环境中提前规避风险。


















