








处理 nginx 代理超时后的请求重发,核心在于区分客户端是否支持幂等重试以及服务端是否允许重复提交。对于 get、head 等非修改类请求,nginx 可以通过配置 proxy_next_upstream 指令自动向后端其他节点发起重试;而对于 post 等可能产生副作用的请求,必须依赖客户端(如浏览器或前端代码)在检测到超时后主动重新发送请求,或者在后端服务中实现基于 token 的防重放机制。
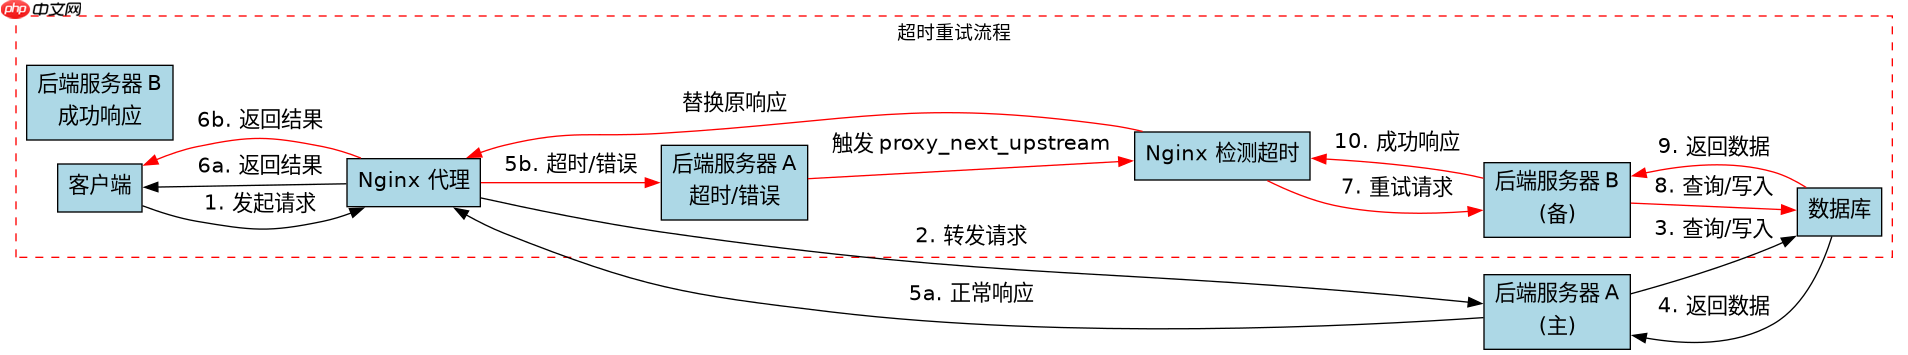
Nginx 如何自动向备用后端重试非幂等请求
当主后端服务器响应超时或返回特定错误时,Nginx 可以自动将请求转发给配置列表中的下一个可用后端服务器。这一过程对客户端完全透明,无需客户端参与重发逻辑。通过设置 proxy_next_upstream 参数,可以指定在哪些条件下触发这种内部重试机制。
server {
    listen 80;
    server_name example.com;

    location /api/ {
        # 定义上游服务器组
        upstream backend_pool {
            server 192.168.1.10:8080;
            server 192.168.1.11:8080;
            server 192.168.1.12:8080;
        }

        proxy_pass http://backend_pool;

        # 关键配置:定义重试条件
        # error: 500, 502, 503, 504 等错误
        # timeout: 连接或读取超时
        # invalid_header: 无效响应头
        # http_500: 仅针对 HTTP 500 状态码
        # http_502: 仅针对 HTTP 502 状态码
        # http_503: 仅针对 HTTP 503 状态码
        # http_504: 仅针对 HTTP 504 状态码
        # off: 关闭重试
        proxy_next_upstream error timeout invalid_header http_500 http_502 http_503 http_504;

        # 限制最大重试次数,防止无限循环
        proxy_next_upstream_tries 3;
    }
}
在上述配置中,如果第一个后端 192.168.1.10 在 proxy_connect_timeout 或 proxy_read_timeout 规定的时间内没有响应,或者返回了 500-504 之间的错误码,Nginx 会自动尝试连接 192.168.1.11。这个过程会一直持续,直到成功获取响应或所有后端都失败。需要注意的是,虽然 Nginx 会自动重试,但如果后端业务逻辑不是幂等的(例如创建订单),多次重试可能导致数据重复。因此,通常建议仅在非幂等操作或后端具备去重能力时使用此功能,或者配合 proxy_next_upstream_error 和 proxy_next_upstream_timeout 更精细地控制。
客户端如何在超时后安全地重新发送 POST 请求
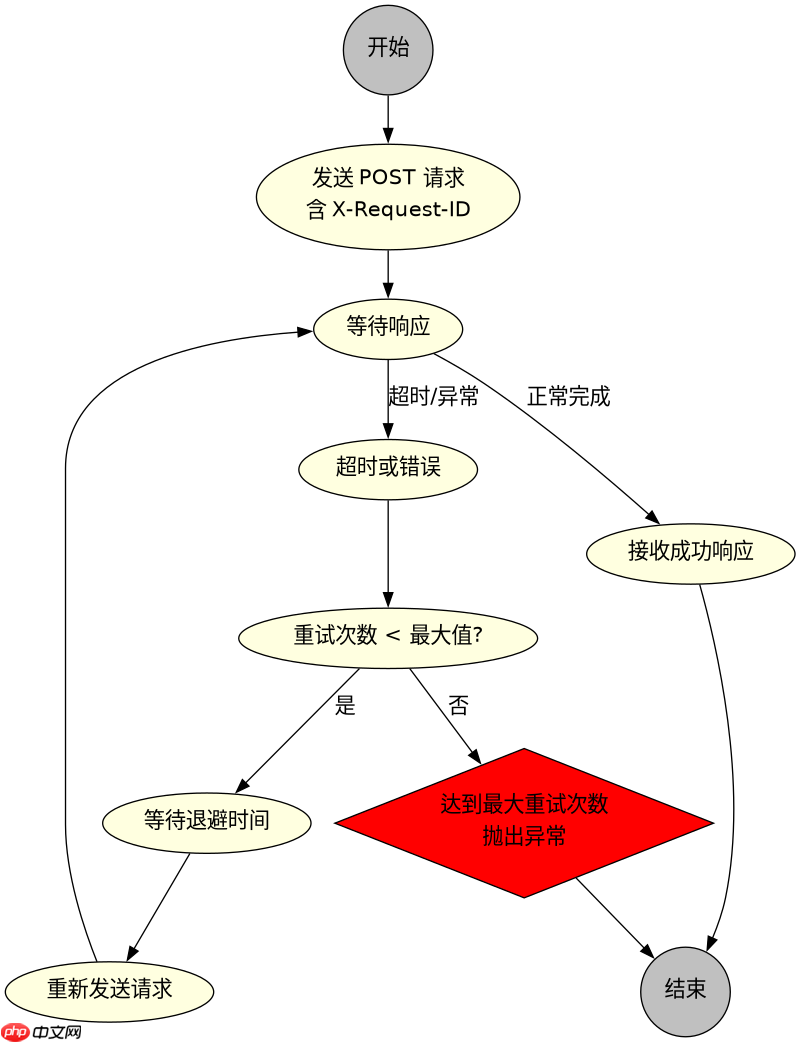
对于涉及数据写入的 POST 请求,Nginx 默认不会自动重试,因为无法保证第二次请求与第一次请求的内容一致,且可能导致数据库记录重复。此时,重发责任落在客户端身上。开发者需要在前端代码中捕获网络超时异常,并实现指数退避或简单的重试策略。同时,为了防止因网络延迟导致的前端误判(即请求其实已到达后端但响应慢),应引入唯一请求标识符(Request ID)或乐观锁机制。


// 前端 JavaScript 示例:带重试机制的 POST 请求
async function submitWithRetry(url, data, retries = 3) {
    for (let i = 0; i < retries; i++) {
        try {
            const requestId = Date.now() + Math.random().toString(36).substr(2, 9);
            const response = await fetch(url, {
                method: 'POST',
                headers: {
                    'Content-Type': 'application/json',
                    'X-Request-ID': requestId // 传递唯一ID供后端去重
                },
                body: JSON.stringify(data),
                signal: AbortSignal.timeout(5000) // 设置5秒超时
            });

            if (!response.ok) {
                throw new Error(`HTTP error! status: ${response.status}`);
            }

            return await response.json();
        } catch (error) {
            console.warn(`Attempt ${i + 1} failed:`, error.message);
            if (i === retries - 1) {
                throw error; // 最后一次重试失败,抛出异常
            }
            // 等待一段时间后重试,避免立即压垮服务器
            await new Promise(resolve => setTimeout(resolve, 1000 * (i + 1)));
        }
    }
}

// 调用示例
submitWithRetry('/api/create-order', { item: 'widget' })
    .then(result => console.log('Success:', result))
    .catch(err => console.error('Failed:', err));
在这个前端示例中,我们使用了 AbortSignal.timeout 来设定请求超时时间。如果超时,fetch 会抛出异常,进入 catch 块。接着,代码会检查剩余的重试次数,如果没有达到上限,则等待一段递增的时间(1秒、2秒...)后再次发起请求。关键在于添加了 X-Request-ID 头部,这个唯一的标识符会被传递给后端。后端在处理请求前,可以检查该 ID 是否已经处理过,从而避免重复执行相同的业务逻辑。这种“客户端重试 + 后端去重”的组合是处理非幂等请求超时的最佳实践。
后端如何基于 X-Request-ID 实现请求去重
当前端携带 X-Request-ID 进行重试时,后端服务需要能够识别并忽略重复的请求。这通常通过在内存缓存(如 Redis 或本地 Map)中存储已处理的 Request ID 来实现。当收到新请求时,先检查 ID 是否存在,若存在则直接返回之前的结果或视为成功,若不存在则执行业务逻辑并将 ID 存入缓存,设置一个合理的过期时间以防止缓存无限增长。
// Python Flask 伪代码示例:基于 Redis 的去重中间件
import uuid
import redis
from flask import request, jsonify

redis_client = redis.Redis(host='localhost', port=6379, db=0)

@app.before_request
def check_duplicate_request():
    request_id = request.headers.get('X-Request-ID')

    if not request_id:
        # 如果没有提供 ID,生成一个并警告(可选)
        request_id = str(uuid.uuid4())

    # 检查 Redis 中是否已存在该 ID
    # SETNX 命令:只有键不存在时才设置,返回 1 表示成功,0 表示已存在
    is_new = redis_client.setnx(f"request_lock:{request_id}", "processing", ex=300)

    if not is_new:
        # 如果 ID 已存在,说明是重复请求
        # 这里可以根据业务需求选择返回 409 Conflict 或直接返回成功
        # 假设我们之前已经处理过并缓存了结果
        cached_result = redis_client.get(f"result:{request_id}")
        if cached_result:
            return jsonify(eval(cached_result)), 200
        else:
            # 如果正在处理中且无缓存,可返回 429 Too Many Requests 或等待
            return jsonify({"error": "Duplicate request detected"}), 409

    # 将 request_id 附加到当前请求上下文,供后续使用
    g.request_id = request_id

@app.after_request
def save_result(response):
    request_id = getattr(g, 'request_id', None)
    if request_id and response.status_code == 200:
        # 将成功响应的结果缓存起来,以便重复请求时直接返回
        redis_client.set(f"result:{request_id}", response.get_data(as_text=True), ex=300)
    return response

@app.route('/api/create-order', methods=['POST'])
def create_order():
    # 业务逻辑...
    order_data = request.json
    # ... 处理订单 ...
    return jsonify({"status": "success", "order_id": 12345})
在后端实现中,setnx 操作保证了原子性,即使多个请求同时到达,也只有一个能成功获取锁。一旦业务逻辑执行完毕,结果被缓存,后续的相同 X-Request-ID 请求就能直接获得响应,而无需再次执行耗时的数据库操作。这种方法不仅解决了超时重发导致的重复数据问题,还提升了系统的整体性能和一致性。需要注意的是,缓存的过期时间(ex=300)应根据业务场景调整,确保在合理的时间窗口内有效,既防止长期占用内存,又覆盖可能的网络波动重试周期。


















