








javascript 柯里化函数参数缓存通过返回闭包来保存已传入的参数,并在后续调用中合并新旧参数。实现的核心是创建一个内部函数,该函数持有原始参数列表的副本,每次调用时检查是否传入了新参数,若有则追加到缓存中,若未传参则直接返回最终计算结果。
如何编写支持多参数累积的通用柯里化工具
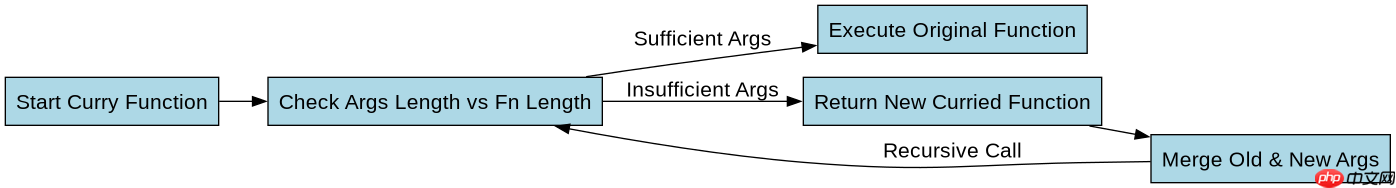
编写通用柯里化工具需要利用函数的 length 属性判断剩余所需参数数量。当累计传入的参数不足时,返回一个新的函数继续接收参数;当参数充足时,执行原函数并返回结果。这种方法允许用户以任意顺序分批传入参数,例如先传部分参数,稍后再传其余参数。
function curry(fn) {
  return function curried(...args) {
    if (args.length >= fn.length) {
      return fn.apply(this, args);
    } else {
      return function(...nextArgs) {
        return curried.apply(this, args.concat(nextArgs));
      };
    }
  };
}

const add = (a, b, c) => a + b + c;
const curriedAdd = curry(add);

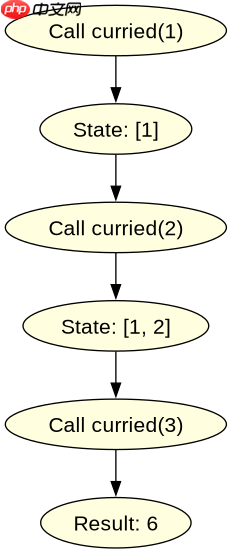
console.log(curriedAdd(1)(2)(3)); // 6
console.log(curriedAdd(1, 2)(3)); // 6
console.log(curriedAdd(1)(2, 3)); // 6
上述代码展示了基于 Function.prototype.length 的标准实现。它首先检查当前传入的 args 长度是否达到目标函数的预期长度。如果未达到,则返回一个接受剩余参数的新函数,该新函数在调用时会再次进入 curried 逻辑,将之前的参数与新的参数拼接后继续判断。这种递归结构确保了参数可以分多次提交,直到满足所有参数要求为止。
立即学习“Java免费学习笔记(深入)”;

如何处理带有默认值或可选参数的复杂场景
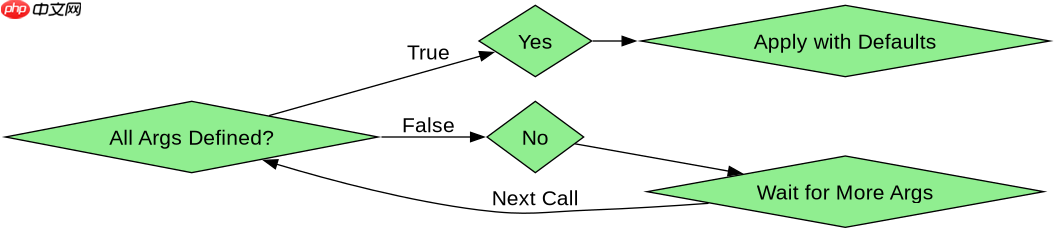
处理带有默认值的参数时,简单的长度判断可能失效,因为调用者可能省略了某些参数。此时需要结合 arguments 对象或显式传递占位符(如 undefined)来处理。更稳健的做法是在内部维护一个参数数组,只有当所有必需参数都提供非空值时才触发执行,否则继续等待输入。
function curryWithDefaults(fn, defaults = {}) {
  return function curried(...args) {
    const mergedArgs = args.map((arg, i) =>
      arg === undefined ? defaults[i] : arg
    );

    if (mergedArgs.every(arg => arg !== undefined)) {
      return fn.apply(this, mergedArgs);
    } else {
      return function(...nextArgs) {
        return curried.apply(this, [...args, ...nextArgs]);
      };
    }
  };
}

const greet = (name, age, city) => `${name}, ${age}, ${city}`;
const curriedGreet = curryWithDefaults(greet, ["Unknown", 0, "N/A"]);

console.log(curriedGreet("Alice")("30")()); // Alice, 30, N/A
这个增强版柯里化函数引入了默认值机制。它在每次调用时都会将传入的参数与预设的默认值进行合并。如果合并后的参数列表中仍存在 undefined,说明条件尚未满足,因此返回一个新的函数继续收集参数。一旦所有参数都被填充,就调用原始函数。这种方式特别适用于配置项较多且大部分可以使用默认值的场景,提高了 API 的灵活性。
为什么递归返回的新函数能正确保留上下文状态
递归返回的新函数之所以能保留状态,是因为 JavaScript 的闭包特性。每个返回的函数实例都引用了其外层作用域中的变量,包括原始参数列表和待执行的函数。这些变量在内存中不会被垃圾回收,直到所有关联的函数实例不再被引用。这种机制使得参数可以在不同层级的函数调用之间传递和累积,而不会丢失任何中间状态。

















