








slice() 和 substring() 在负数索引处理上有何区别
选择 slice() 还是 substring() 主要取决于你是否需要支持负数索引。两者都能截取子字符串,但 slice() 将负数视为从末尾倒数的位置,而 substring() 会将负数强制转换为 0。如果你的业务逻辑中包含基于末尾位置的偏移量计算,使用 slice() 会更直观且不易出错。
const str = 'JavaScript';
console.log(str.slice(0, 4)); // "Java"
console.log(str.substring(0, 4)); // "Java"

console.log(str.slice(-4)); // "ript"
console.log(str.substring(-4)); // "JavaScript" (负数被当作 0)
在实际开发中,如果不确定输入是否可能为负数,或者需要兼容老旧代码,建议显式处理负数情况。例如,在使用 substring() 时,可以先判断参数并加上长度修正。对于大多数现代应用场景,直接使用 slice() 是更推荐的做法,因为它能更准确地表达“倒数第 N 个字符”的意图。
substr() 为何不推荐使用以及其替代方案是什么
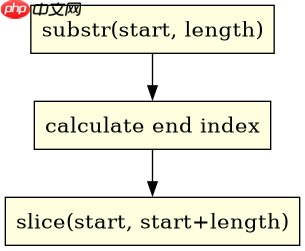
substr() 方法已被标记为遗留特性,不应在新代码中使用。它的主要缺陷在于第二个参数的含义与 slice() 不同:它表示截取的长度,而不是结束索引。这种差异容易导致混淆,尤其是在处理动态长度时。推荐使用 slice() 作为替代,只需将起始位置和长度转换为起始和结束位置即可。

立即学习“Java免费学习笔记(深入)”;
const str = 'Hello World';
// substr(start, length)
console.log(str.substr(6, 5)); // "World"

// slice(start, end) - 替代方案
console.log(str.slice(6, 11)); // "World" (6 + 5 = 11)
由于 substr() 仅出于兼容性原因存在,且可能在未来的 JavaScript 版本中被移除,开发者应养成使用 slice() 的习惯。通过简单的数学运算(起始位置 + 长度 = 结束位置),可以无缝替换所有 substr() 调用,从而保持代码的现代性和可维护性。
当输入包含 Unicode 代理对时这些方法会如何表现
当字符串包含超出基本多文种平面(BMP)的字符(如 Emoji 或某些汉字)时,slice()、substring() 和 substr() 都会按 UTF-16 编码单元进行切割,这可能导致截断的代理对,产生乱码或不可见字符。这些方法无法识别完整的 Unicode 码位。
const emojiStr = 'A?B'; // A + Emoji + B
console.log(emojiStr.length); // 4 (A, High Surrogate, Low Surrogate, B)
console.log(emojiStr.slice(0, 2)); // "A\uD83D" (截断了 Emoji)
console.log(emojiStr.slice(0, 3)); // "A\uD83D\uDE00" (完整 Emoji)
如果需要正确处理 Unicode 字符,应使用 String.prototype.codePointAt() 配合循环,或者使用第三方库如 grapheme-splitter。在现代浏览器环境中,也可以使用展开运算符 [...str] 将字符串拆分为字符数组,然后按需截取,这样可以确保每个 Unicode 码位都被完整保留。


















