








java 异常处理在正常流程中的性能开销极低,几乎可以忽略不计,但在抛出和捕获异常时会产生显著的性能损耗。这种差异源于 jvm 对正常代码路径的优化与异常处理机制的底层实现方式不同。理解这一点的关键在于区分“声明/定义”异常的开销与“抛出/捕获”异常的开销,并在实际开发中避免将异常用于常规的流程控制。

为什么抛出异常比正常执行慢得多
抛出异常之所以慢,是因为 JVM 需要构建完整的调用栈快照(Stack Trace)并查找匹配的 catch 块。这个过程涉及内存分配、对象创建和遍历调用栈,时间复杂度远高于普通的条件判断。相比之下,正常执行路径下的 try-catch 结构本身并不产生额外开销,JVM 甚至可能将其优化为无开销的保护区域。
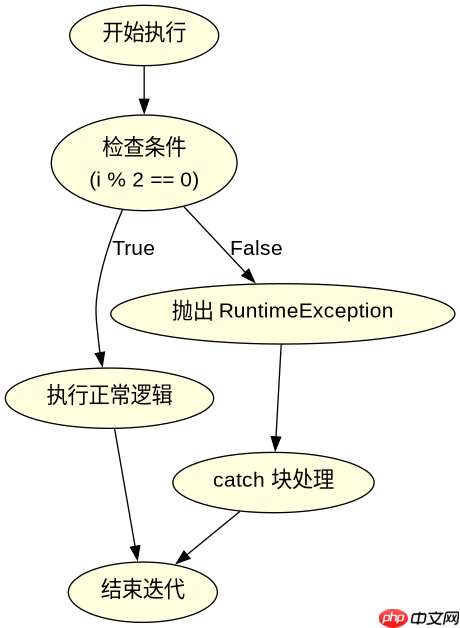
public class ExceptionPerformance {
    public static void main(String[] args) {
        long start = System.nanoTime();
        int iterations = 10_000_000;

        // 正常路径:使用返回值判断
        for (int i = 0; i < iterations; i++) {
            if (i % 2 == 0) {
                // 正常逻辑
            }
        }
        long normalTime = System.nanoTime() - start;

        // 异常路径:抛出并捕获异常
        start = System.nanoTime();
        for (int i = 0; i < iterations; i++) {
            try {
                if (i % 2 != 0) {
                    throw new RuntimeException("Odd number");
                }
            } catch (RuntimeException e) {
                // 捕获异常
            }
        }
        long exceptionTime = System.nanoTime() - start;

        System.out.println("Normal: " + normalTime);
        System.out.println("Exception: " + exceptionTime);
    }
}
运行上述代码通常会发现,异常路径的执行时间是正常路径的数十倍甚至上百倍。这是因为每次抛出异常时,JVM 都会调用 fillInStackTrace() 来记录当前线程的调用状态,包括方法名、行号和局部变量信息。这一过程需要遍历整个调用栈并复制相关数据,导致大量的 CPU 周期消耗和垃圾回收压力。
立即学习“Java免费学习笔记(深入)”;

如何优化异常处理以减少性能影响
为了最小化异常处理的性能开销,开发者应遵循“异常仅用于异常情况”的原则。这意味着不应将异常作为常规的控制流手段,而应在真正发生错误、非法状态或不可恢复的条件时才抛出异常。此外,可以通过减少异常对象的创建频率、复用异常实例或使用更轻量级的错误码机制来进一步优化性能。
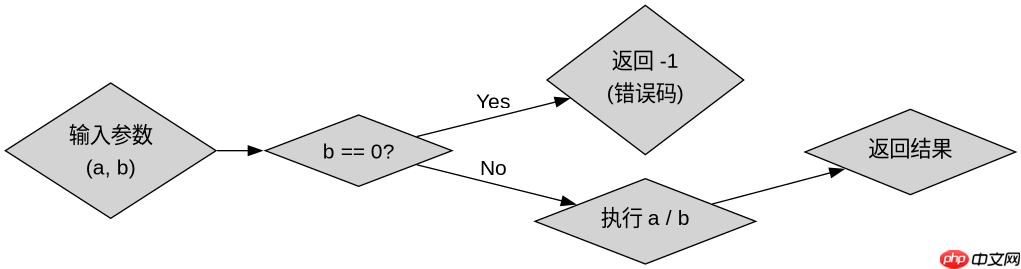
public class OptimizedErrorHandling {
    public static int divide(int a, int b) {
        if (b == 0) {
            return -1; // 使用特殊值表示错误
        }
        return a / b;
    }

    public static void main(String[] args) {
        int result = divide(10, 0);
        if (result == -1) {
            System.out.println("Division by zero");
        } else {
            System.out.println("Result: " + result);
        }
    }
}在上述示例中,divide 方法通过返回特殊值 -1 来表示除零错误,而不是抛出 ArithmeticException。这种方式避免了异常处理的开销,适用于那些错误发生频率较高且可预见的场景。然而,这种方法牺牲了代码的可读性和类型安全性,因此需要根据具体需求权衡使用。对于大多数应用而言,保持异常处理的简洁性和语义清晰性更为重要,除非性能瓶颈明确指向异常处理部分。
异常处理在不同场景下的适用性分析
在实际开发中,异常处理的适用性取决于错误的性质和处理策略。对于可预期的错误(如用户输入无效),使用返回值或可选类型(如 Optional)通常更高效;而对于不可预期的错误(如网络超时或数据库连接失败),异常处理则是必要的,因为它能够确保错误不会静默丢失。此外,框架层面的异常处理(如 Spring 的全局异常处理器)虽然引入了额外的抽象层,但其设计初衷是为了提高代码的可维护性和一致性,而非追求极致性能。




















