








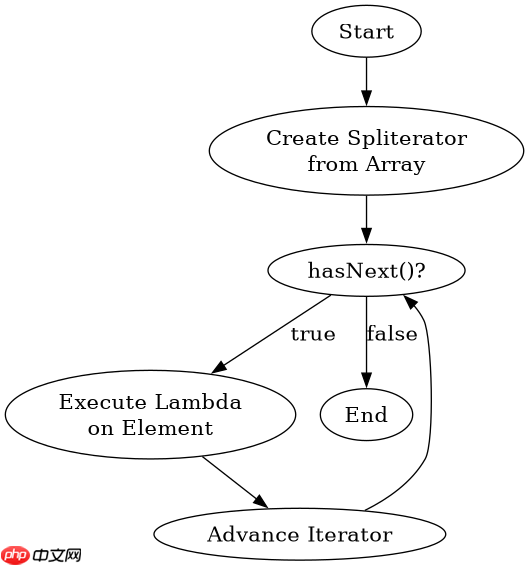
在 arrays.spliterator() 中使用 lambda 表达式,核心是将 lambda 作为参数传递给 foreachremaining 方法。由于 spliterator 接口中的 foreachremaining 接收的是函数式接口 consumer<t></t>,你可以直接传入一个 lambda 来定义对每个元素的消费逻辑。这样做的好处是无需显式创建循环或迭代器对象,代码更简洁且能利用并行流的优势。

如何为特定类型数组创建 Spliterator 并遍历
针对具体类型的数组(如 int[] 或 String[]),应使用 Arrays 类提供的静态工厂方法获取对应的 Spliterator 实例。这些方法返回的是专门优化过的 spliterator,能够正确处理数组的索引和边界。获取实例后,调用 forEachRemaining 并传入 Lambda 即可开始遍历。
import java.util.Arrays;
import java.util.Spliterator;
import java.util.stream.Stream;

public class Main {
    public static void main(String[] args) {
        String[] names = {"Alice", "Bob", "Charlie"};

        // 1. 获取 String 数组的 Spliterator
        Spliterator<String> stringSpliterator = Arrays.spliterator(names);

        // 2. 使用 Lambda 遍历剩余元素
        stringSpliterator.forEachRemaining(name -> System.out.println("Name: " + name));

        // 或者结合 Stream 使用
        StreamSupport.stream(stringSpliterator, false)
                     .filter(n -> n.length() > 3)
                     .forEach(n -> System.out.println("Filtered: " + n));
    }
}
上述代码首先通过 Arrays.spliterator(names) 创建了 String 数组的分割迭代器。接着,forEachRemaining 接收 Lambda 表达式 (name) -> System.out.println(...),该表达式定义了如何处理每个元素。最后展示了如何通过 StreamSupport.stream 将 spliterator 转换为流,以便进行更复杂的过滤操作。
立即学习“Java免费学习笔记(深入)”;

如何在并行处理中利用 Lambda 分割数据
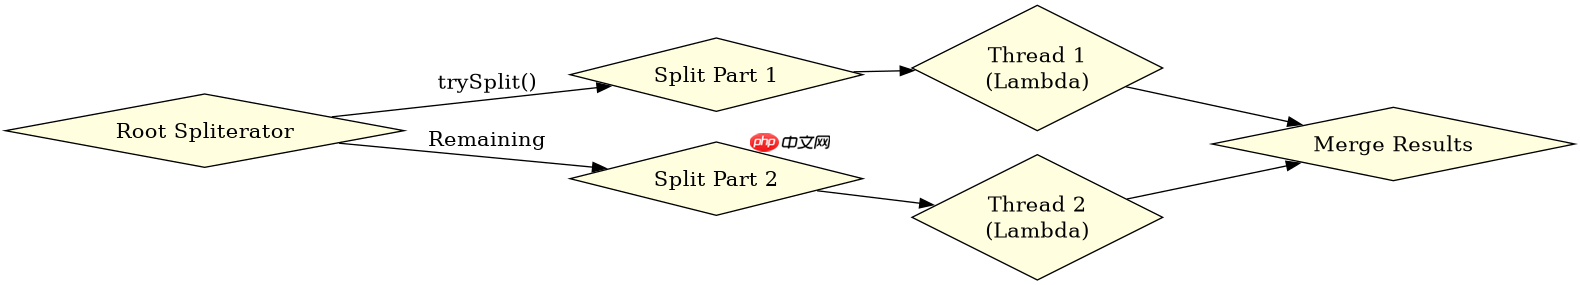
当需要并行处理数组数据时,Spliterator 的 trySplit 方法可以将数据源划分为两部分。Lambda 表达式在这里主要用于定义子任务的处理逻辑。通过将 spliterator 传递给并行流,JVM 会自动调用 trySplit 并将不同的部分分配给不同的线程,每个线程执行相同的 Lambda 逻辑。
import java.util.Arrays;
import java.util.Spliterator;
import java.util.stream.StreamSupport;

public class ParallelExample {
    public static void main(String[] args) {
        int[] numbers = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

        // 1. 获取 int 数组的 Spliterator
        Spliterator<Integer> intSpliterator = Arrays.spliterator(
            Arrays.stream(numbers).boxed().toArray(Integer[]::new)
        );

        // 2. 创建并行流并使用 Lambda 进行累加模拟
        long sum = StreamSupport.stream(intSpliterator, true)
                                .reduce(0, Integer::sum);

        System.out.println("Parallel Sum: " + sum);

        // 手动演示 trySplit 的行为
        Spliterator<Integer> original = Arrays.spliterator(
            Arrays.stream(numbers).boxed().toArray(Integer[]::new)
        );
        Spliterator<Integer> splitPart = original.trySplit();

        if (splitPart != null) {
            System.out.println("Original remaining: " + original.getExactSizeIfKnown());
            System.out.println("Split part size: " + splitPart.getExactSizeIfKnown());
        }
    }
}
在并行场景中,StreamSupport.stream(spliterator, true) 中的第二个参数 true 表示这是并行流。Lambda 表达式 Integer::sum 被用于 reduce 操作中。JVM 内部会多次调用 trySplit 来划分数据块,每个块由独立的线程处理,最终合并结果。这种机制避免了手动管理线程池的复杂性。
当 Spliterator 为空时 Lambda 是否会被执行
如果 Spliterator 中没有剩余元素(即 hasNext() 返回 false),那么传递给 forEachRemaining 的 Lambda 表达式将不会被执行。这是 Spliterator 的标准行为,确保了对空数据源的零开销处理。开发者无需在 Lambda 内部添加额外的空值检查,因为框架已经保证了这一点。



















