








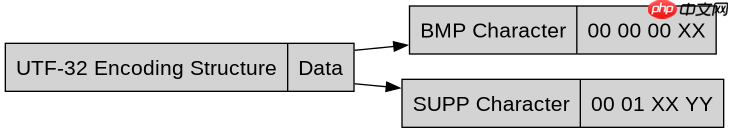
java 中使用 utf-32 处理大字符集(如 emoji、生僻字)的核心做法是调用 charset.forname("utf-32") 获取编码实例,并通过 encode() 方法将字符串转换为字节数组。由于 utf-32 每个码位固定占用 4 个字节,这种编码方式天然支持 unicode 全平面,无需像 utf-8 那样进行变长转换,也避免了代理对(surrogate pairs)的拼接逻辑。在读取或写入数据时,必须显式指定字节序(endianness),因为 utf-32 本身不强制包含 bom,且不同系统可能采用大端或小端存储。

如何正确初始化 UTF-32 编码器并处理字节序
初始化 UTF-32 编码器时,需要明确指定字节序,通常使用 StandardCharsets.UTF_32BE 或 StandardCharsets.UTF_32LE,或者通过 Charset.forName("UTF-32").newEncoder().withByteOrder(ByteOrder.BIG_ENDIAN) 来配置。如果不指定字节序,默认行为可能依赖于平台或具体实现,导致跨平台数据交换时出现乱码。对于大字符集中的字符,如 U+10000 以上的辅助平面字符,UTF-32 直接将其映射为单个 32 位整数,无需拆分。
import java.nio.ByteBuffer;
import java.nio.CharBuffer;
import java.nio.charset.Charset;
import java.nio.charset.CharsetEncoder;
import java.nio.charset.CoderResult;
import java.nio.ByteOrder;

public class Utf32Example {
    public static void main(String[] args) throws Exception {
        // 定义一个包含大字符集的字符串:Emoji (U+1F600) 和 基本汉字
        String input = "\uD83D\uDE00A"; // Smile emoji + 'A'

        // 使用 UTF-32 BE (Big Endian) 编码
        Charset charset = Charset.forName("UTF-32BE");
        CharsetEncoder encoder = charset.newEncoder();

        CharBuffer charBuffer = CharBuffer.wrap(input);
        ByteBuffer byteBuffer = ByteBuffer.allocate(input.length() * 4);

        CoderResult result = encoder.encode(charBuffer, byteBuffer, true);
        if (result.isError()) {
            throw new RuntimeException("Encoding error: " + result);
        }

        byteBuffer.flip();
        System.out.println("Encoded bytes (hex):");
        while (byteBuffer.hasRemaining()) {
            System.out.printf("%02X ", byteBuffer.get());
        }
        System.out.println();

        // 验证解码
        ByteBuffer decodeBuffer = ByteBuffer.wrap(byteBuffer.array(), 0, byteBuffer.limit());
        CharsetDecoder decoder = charset.newDecoder();
        CharBuffer decoded = decoder.decode(decodeBuffer);
        System.out.println("Decoded string: " + decoded.toString());
    }
}
运行上述代码,输出结果将显示每个字符对应 4 个字节。例如,'A' (U+0041) 编码为 00 00 00 41,而 Emoji '?' (U+1F600) 编码为 00 01 F6 00。这证明了 UTF-32 能够直接处理所有 Unicode 码位,无需代理对机制。
立即学习“Java免费学习笔记(深入)”;

如何处理 UTF-32 中的无效码位和替换策略
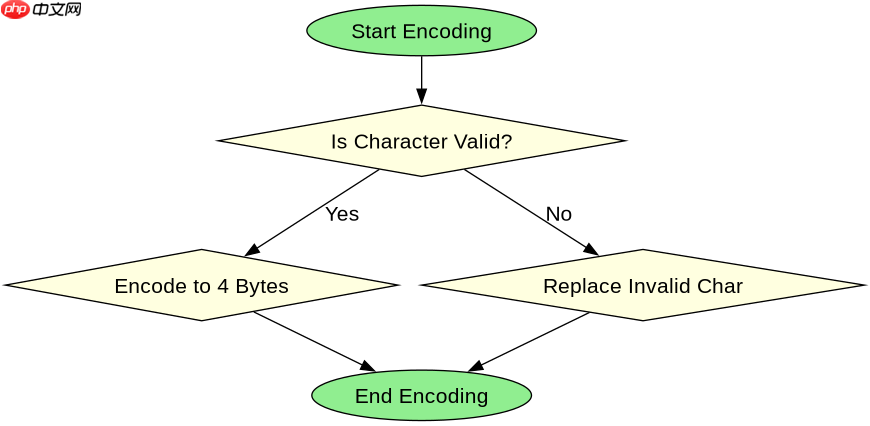
在处理大字符集时,可能会遇到无效的 Unicode 码位(如大于 U+10FFFF 的值)或非字符(Non-characters)。UTF-32 编码器在遇到这些无效输入时,默认会抛出 MalformedInputException。可以通过配置 CodingErrorAction 来处理这些情况,例如使用 REPLACE 动作将无效码位替换为占位符 '?' 或 Unicode 替换字符 \uFFFD。此外,UTF-32 编码不支持部分编码状态,因此每次编码操作都必须是完整的字符序列,否则会导致 CoderResult.UNDERFLOW 错误。
import java.nio.charset.CodingErrorAction;
import java.nio.charset.Charset;
import java.nio.charset.CharsetEncoder;
import java.nio.charset.MalformedInputException;
import java.nio.charset.CoderResult;
import java.nio.ByteBuffer;
import java.nio.CharBuffer;

public class Utf32ErrorHandling {
    public static void main(String[] args) throws Exception {
        String invalidInput = "Valid\uFFFEInvalid"; // \uFFFE is a non-character

        Charset charset = Charset.forName("UTF-32BE");
        CharsetEncoder encoder = charset.newEncoder()
                .onMalformedInput(CodingErrorAction.REPLACE)
                .onUnmappableCharacter(CodingErrorAction.REPLACE);

        CharBuffer charBuffer = CharBuffer.wrap(invalidInput);
        ByteBuffer byteBuffer = ByteBuffer.allocate(invalidInput.length() * 4);

        try {
            CoderResult result = encoder.encode(charBuffer, byteBuffer, true);
            if (result.isError()) {
                System.out.println("Error during encoding: " + result);
            } else {
                System.out.println("Encoding succeeded with replacements.");
            }
        } catch (MalformedInputException e) {
            System.out.println("Malformed input detected: " + e.getInputLength());
        }
    }
}
在上述代码中,通过设置 CodingErrorAction.REPLACE,编码器会将非字符 \uFFFE 替换为默认的替换字符,从而避免抛出异常。这对于处理来自不可信源的数据非常有用,可以确保程序不会因为个别无效字符而崩溃。需要注意的是,UTF-32 编码的字节长度始终是字符数的 4 倍,因此在分配缓冲区时必须预留足够的空间。
基于程序中某个输入、条件或结果的具体问题
当输入字符串包含混合的基本多语言平面(BMP)字符和辅助平面字符时,UTF-32 编码的输出字节流是否保持固定宽度?答案是肯定的。无论字符位于哪个 Unicode 平面,UTF-32 编码始终为每个码位生成 4 个字节。这意味着在处理大字符集时,内存占用和传输带宽的需求是固定的,与字符内容无关。例如,字符串 "Hello" 和 "???" 在 UTF-32 编码下分别占用 5*4=20 字节和 3*4=12 字节,而它们在 UTF-8 下的占用则分别为 5 字节和 9 字节。这种固定宽度的特性使得 UTF-32 在处理随机访问和索引计算时更加高效,但也带来了存储效率较低的问题。



















