








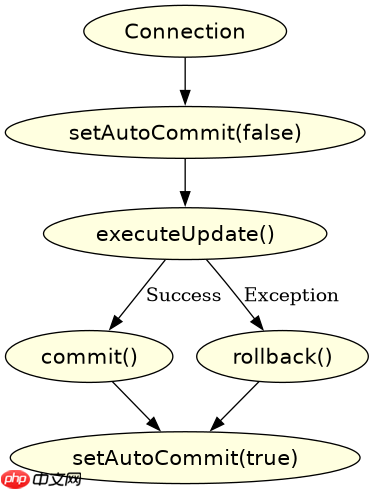
java jdbc 实现数据汇总的核心在于利用 connection 对象的自动提交机制控制事务边界,确保在批量处理或复杂查询期间数据的一致性。具体做法是调用 setautocommit(false) 关闭自动提交,执行完所有相关的 sql 操作后,显式调用 commit() 提交事务,若发生异常则调用 rollback() 回滚。这样能保证汇总过程中的中间状态不会泄露给其他线程,且要么全部成功,要么全部失败。

JDBC 事务中如何正确开启与提交
要开始一个事务,必须获取数据库连接并修改其自动提交属性。默认情况下,JDBC 连接处于自动提交模式,每条语句都会立即生效。通过 setAutoCommit(false) 可以进入事务上下文,此时执行的插入、更新或删除操作仅在当前会话可见,直到调用 commit() 才持久化到数据库。如果在此过程中捕获到 SQLException,应执行 rollback() 以撤销所有更改,防止产生脏数据。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class TransactionExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交,开启事务
            conn.setAutoCommit(false);

            try {
                // 2. 执行具体的业务逻辑,例如汇总数据
                updateSummaryData(conn);

                // 3. 提交事务
                conn.commit();
                System.out.println("事务提交成功");
            } catch (SQLException e) {
                // 4. 发生异常时回滚
                conn.rollback();
                System.err.println("事务回滚: " + e.getMessage());
            } finally {
                // 5. 恢复自动提交状态(可选,取决于连接池配置)
                conn.setAutoCommit(true);
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    private static void updateSummaryData(Connection conn) throws SQLException {
        String sql = "UPDATE summary_table SET total_count = total_count + ? WHERE category_id = ?";
        try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
            pstmt.setInt(1, 10); // 增加的数量
            pstmt.setInt(2, 101); // 分类ID
            pstmt.executeUpdate();
        }
    }
}
上述代码展示了标准的 JDBC 事务流程。首先通过 DriverManager.getConnection 获取连接,随后立即调用 setAutoCommit(false)。在 try 块内部执行具体的 SQL 更新操作,这里模拟了一个汇总计数的增加。如果 updateSummaryData 执行成功,则调用 commit() 使更改永久生效。若任何步骤抛出异常,catch 块将触发 rollback(),确保数据库状态保持不变。最后,在 finally 块中恢复自动提交,以防后续代码因连接状态异常而出错。
立即学习“Java免费学习笔记(深入)”;
事务隔离级别对汇总结果的影响
在并发环境下,多个事务同时读取和写入汇总数据可能导致不一致的结果,如脏读、不可重复读或幻读。JDBC 允许通过 setTransactionIsolation() 设置事务隔离级别,常用的有 READ_COMMITTED 和 REPEATABLE_READ。对于数据汇总场景,通常推荐使用 REPEATABLE_READ 或更高隔离级别,以确保在事务期间读取到的数据不会被其他已提交的事务修改,从而保证汇总计算的准确性。


import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.SQLException;
import java.sql.Statement;

public class IsolationLevelExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 设置事务隔离级别为可重复读
            conn.setTransactionIsolation(Connection.TRANSACTION_REPEATABLE_READ);

            // 关闭自动提交
            conn.setAutoCommit(false);

            try (Statement stmt = conn.createStatement()) {
                // 执行汇总查询
                String querySql = "SELECT SUM(amount) FROM transactions WHERE date = '2023-10-01'";
                var rs = stmt.executeQuery(querySql);
                if (rs.next()) {
                    double total = rs.getDouble(1);
                    System.out.println("汇总总额: " + total);
                }

                // 提交事务
                conn.commit();
            } catch (SQLException e) {
                conn.rollback();
                e.printStackTrace();
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
该示例演示了如何在 JDBC 中设置事务隔离级别。通过调用 conn.setTransactionIsolation(Connection.TRANSACTION_REPEATABLE_READ),确保在当前事务内,即使其他事务提交了新的数据修改,当前事务读取到的数据依然保持一致。这对于数据汇总至关重要,因为如果在汇总过程中其他事务插入了新记录,可能会导致汇总结果被重复计算或遗漏。使用 REPEATABLE_READ 可以避免这类问题,保证汇总结果的稳定性和可靠性。
如何处理事务中的部分失败情况
在实际应用中,事务可能涉及多个步骤,其中某一步骤失败不应影响已成功步骤的回滚。JDBC 提供了保存点(Savepoint)机制,允许在事务中设置标记点,以便在需要时回滚到特定位置而不是整个事务。通过使用 setSavepoint() 创建保存点,并在出错时调用 rollback(savepoint),可以实现细粒度的错误处理,提高系统的健壮性。
以下代码展示了如何使用保存点来处理部分失败的情况。在事务中,先执行第一步操作,然后创建一个保存点。接着执行第二步操作,如果这一步失败,则回滚到保存点,保留第一步的成果,并尝试其他补救措施或记录错误日志。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.Savepoint;
import java.sql.SQLException;

public class SavepointExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);

            try {
                // 第一步:更新用户余额
                updateBalance(conn, 1001, -50);

                // 创建保存点
                Savepoint sp1 = conn.setSavepoint("after_balance_update");

                // 第二步:记录交易日志
                logTransaction(conn, 1001, "withdraw", 50);

                // 提交事务
                conn.commit();
                System.out.println("事务提交成功");
            } catch (SQLException e) {
                try {
                    // 回滚到保存点,保留第一步成果
                    conn.rollback(sp1);
                    System.out.println("回滚到保存点,保留余额更新");
                    // 这里可以添加重试逻辑或补偿措施
                } catch (SQLException ex) {
                    // 如果回滚也失败,则回滚整个事务
                    conn.rollback();
                    System.err.println("事务完全回滚: " + ex.getMessage());
                }
            } finally {
                conn.setAutoCommit(true);
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    private static void updateBalance(Connection conn, int userId, double amount) throws SQLException {
        String sql = "UPDATE users SET balance = balance + ? WHERE id = ?";
        try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
            pstmt.setDouble(1, amount);
            pstmt.setInt(2, userId);
            pstmt.executeUpdate();
        }
    }

    private static void logTransaction(Connection conn, int userId, String type, double amount) throws SQLException {
        String sql = "INSERT INTO transactions (user_id, type, amount) VALUES (?, ?, ?)";
        try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
            pstmt.setInt(1, userId);
            pstmt.setString(2, type);
            pstmt.setDouble(3, amount);
            pstmt.executeUpdate();
        }
    }
}
此示例展示了保存点的实际应用。在 updateBalance 成功后,通过 setSavepoint 创建一个名为 after_balance_update 的保存点。随后执行 logTransaction,如果这一步失败,catch 块会捕获异常并尝试回滚到保存点,从而保留余额更新的成果。这种机制特别适用于那些可以独立处理的部分失败场景,提高了系统的容错能力。



















