








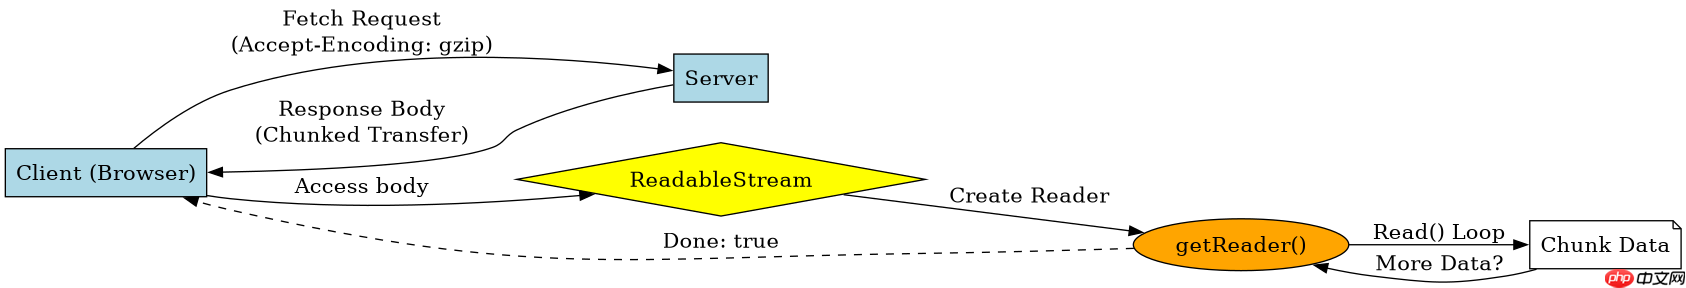
使用 fetch 处理分块数据(chunked data)的核心方法是读取响应体中的 readablestream,并通过 getreader() 获取读取器进行循环拉取。你需要设置请求头 accept-encoding: gzip, deflate 以允许服务器发送压缩的分块内容,并在代码中通过 reader.read() 的循环不断接收 value(二进制块),直到 done 为 true 时停止。这种方式能实现流式处理,避免等待整个响应加载完毕,适合大文件或实时数据推送场景。
如何正确配置请求头以支持分块传输
要让服务器返回分块数据,客户端必须在发起 fetch 请求时显式声明支持压缩编码。通过在 headers 对象中添加 Accept-Encoding 字段并设为 gzip, deflate,可以告知服务器如果资源较大,可以使用这些算法进行分块压缩后传输。如果不设置此头部,某些服务器可能会直接返回未压缩的完整响应,或者拒绝分块传输,导致无法利用流式优势。此外,确保 mode 和 credentials 等参数符合跨域或认证需求,以保证连接建立顺利。
const url = 'https://api.example.com/large-data';

async function fetchChunks() {
  const response = await fetch(url, {
    headers: {
      'Accept-Encoding': 'gzip, deflate'
    }
  });

  if (!response.ok) {
    throw new Error(`HTTP error! status: ${response.status}`);
  }

  // 检查 Content-Length 是否存在,若不存在则确认为分块传输
  const contentLength = response.headers.get('Content-Length');
  console.log('Is chunked:', !contentLength);

  return response.body;
}
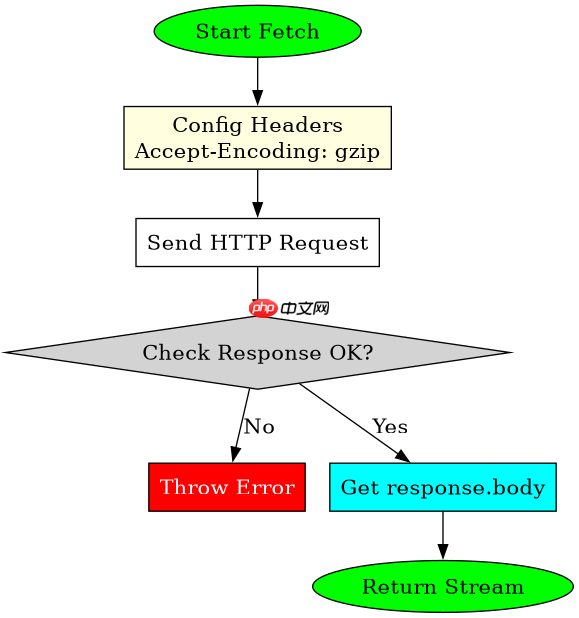
上述代码展示了如何发起一个支持分块传输的请求。关键点在于 Accept-Encoding 的设置。运行该函数后,你将获得一个 ReadableStream 对象。如果服务器支持且资源足够大,响应头中将不会包含 Content-Length,或者会包含 Transfer-Encoding: chunked。此时,你可以将返回的 response.body 传递给后续的流处理逻辑。注意,这里只是建立了连接并获取了流引用,实际的数据读取需要在下一步进行。
立即学习“Java免费学习笔记(深入)”;

如何使用 ReadableStream 读取并合并数据
获取到 ReadableStream 后,调用其 getReader() 方法可以获得一个 ReadableStreamDefaultReader 实例。通过在该实例上循环调用 read() 方法,可以逐个获取数据块。每次调用 read() 都会返回一个 Promise,解析后的对象包含 done 布尔值和 value 字节数组。当 done 为 false 时,value 即为当前分块的二进制数据;当 done 为 true 时,表示流已关闭,读取结束。为了得到完整的原始数据,通常需要将所有的 value 拼接起来,或者根据业务需求逐块处理(如解码 JSON、更新 UI 等)。

async function processStream(stream) {
  const reader = stream.getReader();
  const chunks = [];

  while (true) {
    const { done, value } = await reader.read();

    if (done) break;

    // value 是 Uint8Array,存储当前分块数据
    chunks.push(value);
    console.log(`Received chunk of size: ${value.length}`);
  }

  // 合并所有分块为完整数据
  const totalLength = chunks.reduce((acc, chunk) => acc + chunk.length, 0);
  const combined = new Uint8Array(totalLength);
  let offset = 0;
  for (const chunk of chunks) {
    combined.set(chunk, offset);
    offset += chunk.length;
  }

  return combined;
}
这段代码演示了完整的读取与合并过程。首先创建读取器,然后进入 while 循环。在每次迭代中,await reader.read() 暂停执行直到有新数据到达。收集到的 Uint8Array 被存入 chunks 数组。循环结束后,计算总长度并创建一个新的 Uint8Array 来容纳所有数据,最后通过 set 方法将每个分块复制到正确的位置。最终返回的 combined 变量即为完整的二进制响应体。这种方法确保了即使数据是分块到达的,也能被完整地重组。
如何处理解压后的文本或 JSON 数据
在实际应用中,分块数据往往经过 gzip 压缩,浏览器会自动解压吗?答案取决于环境。在浏览器环境中,fetch 默认会自动处理 gzip 和 deflate 解压,因此你从 value 中拿到的是解压后的原始字节流,无需手动解压。如果数据是 JSON 格式,可以在读取完所有分块后,使用 TextDecoder 将 Uint8Array 转换为字符串,再使用 JSON.parse 解析。对于超大数据,也可以考虑边读边解码,但需注意字符边界问题,通常建议先合并再解码以避免截断多字节字符。
async function fetchAndParseJson(url) {
  const response = await fetch(url, {
    headers: { 'Accept-Encoding': 'gzip' }
  });
  const stream = response.body;
  const reader = stream.getReader();
  const chunks = [];

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    chunks.push(value);
  }

  const totalLength = chunks.reduce((acc, c) => acc + c.length, 0);
  const combined = new Uint8Array(totalLength);
  let offset = 0;
  for (const c of chunks) {
    combined.set(c, offset);
    offset += c.length;
  }

  // 解码为字符串
  const text = new TextDecoder().decode(combined);
  // 解析 JSON
  return JSON.parse(text);
}
此示例展示了从分块流到 JSON 对象的完整转换链路。由于浏览器自动解压,combined 数组中存储的是 UTF-8 编码的原始文本字节。使用 TextDecoder 将其转换为 JavaScript 字符串后,即可安全地调用 JSON.parse。这种模式适用于 API 返回大型 JSON 数组或嵌套对象的情况,能够显著降低内存峰值压力,因为数据是逐步流入而非一次性加载到内存中的。注意,如果数据量极大,合并步骤仍可能占用较多内存,此时可考虑使用更高级的流式 JSON 解析库。


















