








javascript promise 实现异步操作的自动过滤,核心在于利用 promise.allsettled 或 promise.race 结合前置条件判断。具体做法是:在发起请求前,通过一个共享的 map 或 weakmap 缓存正在进行的 promise 实例;当新请求到来时,先检查缓存中是否已存在相同标识(如 url 或 id)的未决 promise。若存在,则直接返回该实例,从而实现“去重”或“过滤”;若不存在,则创建新 promise,存入缓存,并在其 settle(完成或失败)后从缓存中移除,确保后续同类请求能重新发起。这种方法能有效避免重复网络请求、节省带宽并提升用户体验。

如何基于请求 URL 实现防抖与去重?
基于请求 URL 实现防抖与去重,关键在于维护一个全局的请求状态映射表。开发者需要定义一个 pendingRequests 对象,以 URL 为键,值为对应的 Promise 实例。每次发起请求前,先查询该对象:如果键已存在且值仍是 Promise 实例,说明该请求正在进行中,直接返回此实例即可;如果键不存在或值已解析/拒绝,则创建新的 Promise 封装实际请求逻辑,将其存入映射表,并在 finally 块中清理该键。这样,同一 URL 在短时间内多次触发只会执行一次实际的网络 IO,后续调用者共享同一个结果。
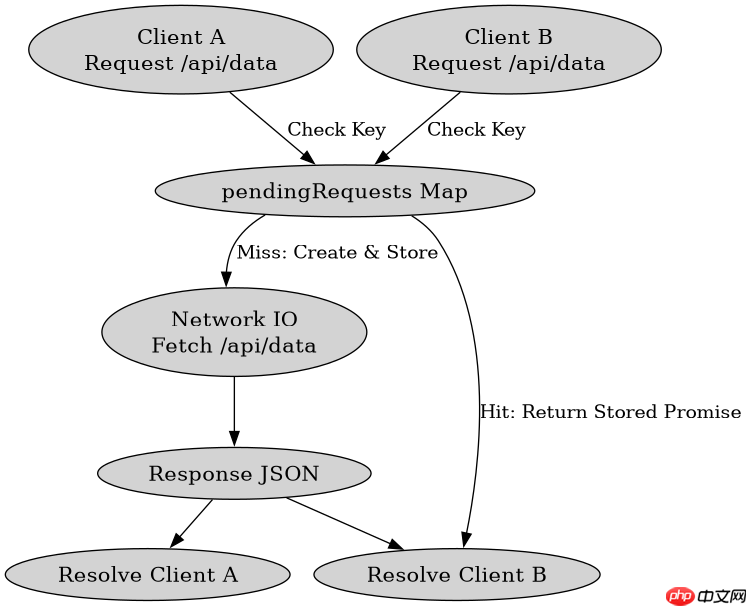
const pendingRequests = new Map();

function fetchWithDedup(url) {
  if (pendingRequests.has(url)) {
    return pendingRequests.get(url);
  }

  const promise = fetch(url)
    .then(res => res.json())
    .catch(err => { throw err; })
    .finally(() => {
      pendingRequests.delete(url);
    });

  pendingRequests.set(url, promise);
  return promise;
}

// 测试用例
fetchWithDedup('/api/data')
  .then(data => console.log('Result:', data));

// 立即再次调用,将复用上述 Promise
fetchWithDedup('/api/data')
  .then(data => console.log('Duplicate call result:', data));
如何处理并发请求中的错误隔离?
在处理并发请求时,若使用 Promise.all,任何一个请求失败都会导致整体 rejected,无法获取其他成功请求的结果。为实现错误隔离,应改用 Promise.allSettled。该 API 会等待所有传入的 Promise settled(无论 fulfilled 还是 rejected),并返回一个包含每个 Promise 状态的数组。开发者可以遍历该数组,筛选出 status: 'fulfilled' 的结果作为有效数据,而忽略或单独处理 status: 'rejected' 的错误项。这种方式确保了单个异步操作的失败不会“污染”整个批量操作,适合用于加载多个独立资源(如用户信息、头像、配置等)的场景,即使部分资源加载失败,其他资源仍可正常使用。

立即学习“Java免费学习笔记(深入)”;

const urls = ['/api/user', '/api/avatar', '/api/config'];

Promise.allSettled(urls.map(url => fetch(url).then(r => r.json())))
  .then(results => {
    const successData = results
      .filter(p => p.status === 'fulfilled')
      .map(p => p.value);

    const errors = results
      .filter(p => p.status === 'rejected')
      .map(p => p.reason);

    console.log('Success:', successData);
    console.log('Errors:', errors);
  });
当 Promise 被手动 reject 时,缓存机制会如何响应?
当 Promise 被手动 reject 时,缓存机制的响应取决于清理逻辑的位置。在上述示例中,清理逻辑位于 .finally() 块中,这意味着无论 Promise 是 fulfilled 还是 rejected,都会在最终阶段执行 pendingRequests.delete(url)。因此,即使请求失败,该 URL 对应的缓存条目也会被清除。下一次对同一 URL 的调用将不再命中缓存,而是创建一个新的 Promise 实例重新发起请求。这种设计是合理的,因为失败的请求通常意味着临时错误(如网络抖动、服务器 500),重试是必要的。如果希望失败后不重试,可将清理逻辑移至 .then() 而非 .finally(),或在 catch 中设置更复杂的策略(如指数退避)。但标准实践中,finally 确保缓存及时释放,避免内存泄漏和永久阻塞。


















