








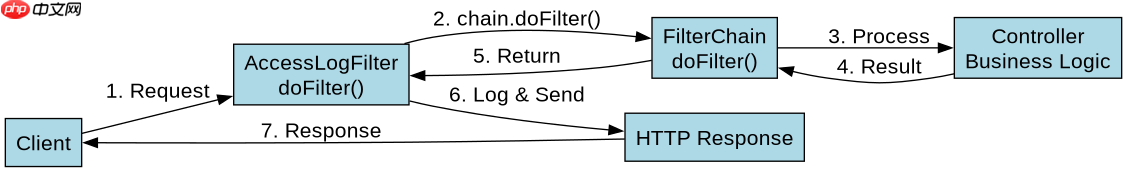
在 java 中记录 http 访问日志,最标准且高效的做法是利用 servlet 规范中的 filter 机制拦截请求,结合 httpservletrequest 获取关键信息并写入日志。通过实现 javax.servlet.filter(或 jakarta ee 的 jakarta.servlet.filter),可以在请求到达 controller 之前和响应返回之后,分别记录请求方法、url、状态码和耗时,从而形成完整的访问链路日志。
如何配置 Filter 以捕获请求与响应元数据
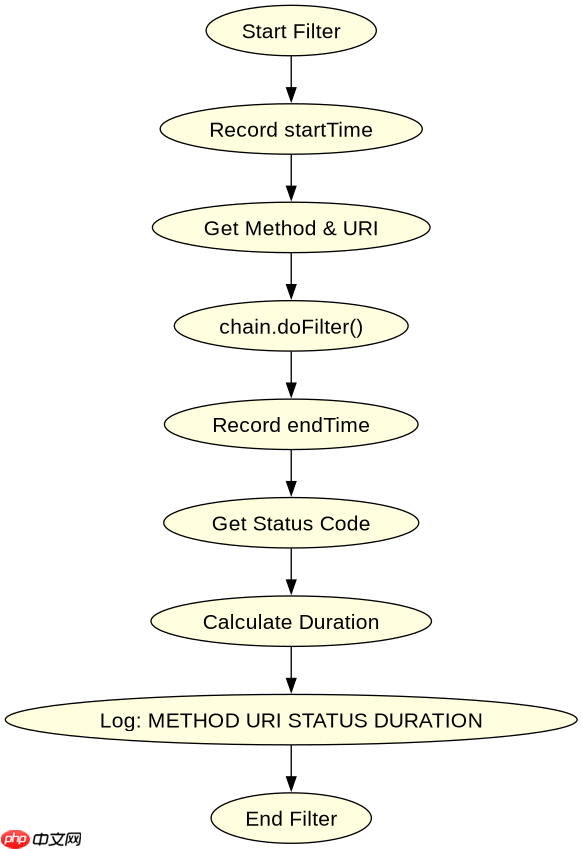
要捕获 HTTP 访问日志,需要创建一个实现了 Filter 接口的类,并在其中重写 doFilter 方法。在该方法中,首先记录请求开始时间,然后调用 chain.doFilter() 放行请求,待响应生成后,再次获取响应状态码并计算耗时。这种方式不侵入业务代码,能统一处理所有进入应用的 HTTP 请求。
import javax.servlet.*;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
import java.io.IOException;
import java.util.logging.Logger;

public class AccessLogFilter implements Filter {
    private static final Logger logger = Logger.getLogger(AccessLogFilter.class.getName());

    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {
        HttpServletRequest httpRequest = (HttpServletRequest) request;
        HttpServletResponse httpResponse = (HttpServletResponse) response;

        long startTime = System.currentTimeMillis();
        String method = httpRequest.getMethod();
        String uri = httpRequest.getRequestURI();

        try {
            chain.doFilter(request, response);
        } finally {
            long endTime = System.currentTimeMillis();
            int status = httpResponse.getStatus();
            long duration = endTime - startTime;

            // 记录格式:METHOD URI STATUS DURATION(ms)
            logger.info(String.format("%s %s %d %dms", method, uri, status, duration));
        }
    }
}
上述代码展示了核心的过滤逻辑。在 finally 块中记录日志确保了即使发生异常也能输出状态码(通常为 500)。使用 java.util.logging 作为基础日志框架,实际项目中可替换为 Logback 或 Log4j2。该过滤器需通过 @WebFilter 注解或在 web.xml 中注册,指定拦截路径如 /* 以覆盖所有请求。
立即学习“Java免费学习笔记(深入)”;
如何处理请求体与查询参数以避免性能损耗
直接读取请求体(Body)会导致流被消费,后续业务代码无法再次读取,因此必须使用包装器(Wrapper)来缓存输入流。对于查询参数(Query Parameters),由于它们位于 URL 中而非流中,可以直接从 HttpServletRequest 获取,无需特殊处理。在 Filter 中记录日志时,应优先记录 URL 和参数,对 Body 内容仅在调试模式下谨慎记录,以免因大文件上传导致内存溢出或性能下降。

import javax.servlet.*;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletRequestWrapper;
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStreamReader;

public class CachedBodyHttpServletRequest extends HttpServletRequestWrapper {
    private byte[] cachedBody;

    public CachedBodyHttpServletRequest(HttpServletRequest request) throws IOException {
        super(request);
        // 缓存请求体
        BufferedReader reader = request.getReader();
        StringBuilder sb = new StringBuilder();
        String line;
        while ((line = reader.readLine()) != null) {
            sb.append(line);
        }
        cachedBody = sb.toString().getBytes();
    }

    @Override
    public ServletInputStream getInputStream() throws IOException {
        return new CachedBodyServletInputStream(cachedBody);
    }

    @Override
    public BufferedReader getReader() throws IOException {
        return new BufferedReader(new InputStreamReader(getInputStream()));
    }
}

// 辅助类:提供 ByteArrayInputStream 的 ServletInputStream 实现
class CachedBodyServletInputStream extends ServletInputStream {
    private final java.io.ByteArrayInputStream buffer;
    public CachedBodyServletInputStream(byte[] content) {
        this.buffer = new java.io.ByteArrayInputStream(content);
    }
    @Override
    public boolean isFinished() { return buffer.available() == 0; }
    @Override
    public boolean isReady() { return true; }
    @Override
    public void setReadListener(ReadListener listener) {}
    @Override
    public int read() { return buffer.read(); }
}
在实际应用中,若需记录 POST 请求的 JSON 或表单数据,可使用上述 CachedBodyHttpServletRequest 包装原始请求。在 Filter 中,先判断是否为 POST 请求且 Content-Type 为 application/json,若是则创建包装实例并传入链式调用。这样,Controller 层仍能正常读取请求体,而 Filter 层已保存副本用于日志记录。注意,仅当业务确实需要审计请求体时才启用此功能,否则会增加不必要的 I/O 开销。
如何根据特定条件过滤或格式化日志输出
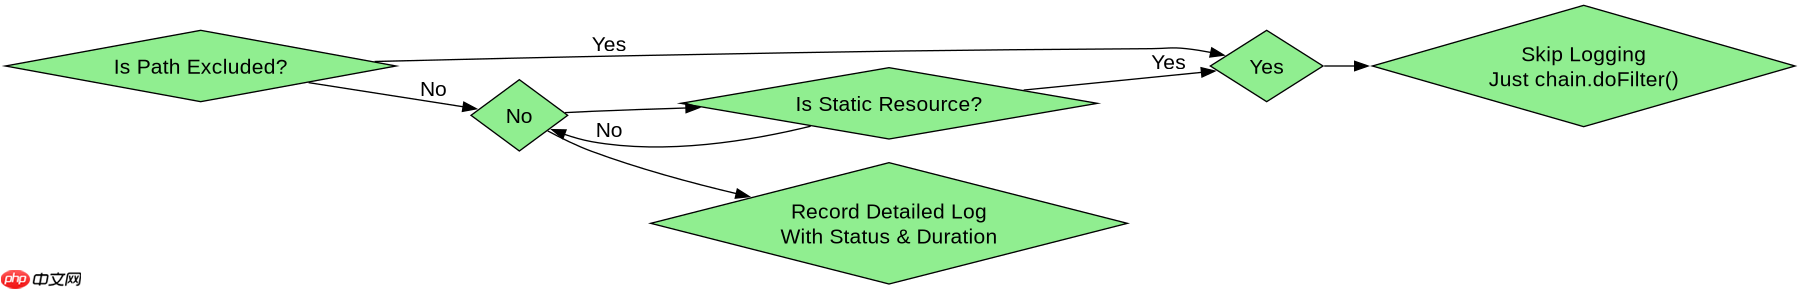
并非所有 HTTP 请求都需要同等粒度的日志记录。例如,健康检查接口(如 /health)或静态资源请求(.css, .js, .png)通常产生大量低价值日志。可以通过在 Filter 中添加条件判断,对这些请求跳过详细日志记录,或仅记录极简信息。此外,可根据用户角色或请求头动态调整日志级别,确保生产环境日志既完整又不冗余。
以下代码演示了如何在 Filter 中集成条件过滤逻辑:
import javax.servlet.*;
import javax.servlet.http.HttpServletRequest;
import javax.servlet.http.HttpServletResponse;
import java.io.IOException;
import java.util.Arrays;
import java.util.List;
import java.util.logging.Level;
import java.util.logging.Logger;

public class SmartAccessLogFilter implements Filter {
    private static final Logger logger = Logger.getLogger(SmartAccessLogFilter.class.getName());
    private static final List<String> EXCLUDED_PATHS = Arrays.asList("/health", "/favicon.ico");
    private static final List<String> STATIC_EXTENSIONS = Arrays.asList(".css", ".js", ".png", ".jpg", ".ico");

    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain)
            throws IOException, ServletException {
        HttpServletRequest httpRequest = (HttpServletRequest) request;
        HttpServletResponse httpResponse = (HttpServletResponse) response;

        String uri = httpRequest.getRequestURI();
        boolean shouldLog = !EXCLUDED_PATHS.contains(uri) &&
                            STATIC_EXTENSIONS.stream().noneMatch(uri::endsWith);

        if (!shouldLog) {
            chain.doFilter(request, response);
            return;
        }

        long startTime = System.currentTimeMillis();
        try {
            chain.doFilter(request, response);
        } finally {
            long duration = System.currentTimeMillis() - startTime;
            int status = httpResponse.getStatus();

            // 根据状态码设置日志级别
            Level level = (status >= 500) ? Level.SEVERE : Level.INFO;
            logger.log(level, String.format("[%s] %s %d %dms",
                httpRequest.getMethod(), uri, status, duration));
        }
    }
}
该实现通过排除路径列表和静态资源后缀,显著减少了无效日志条目。同时,根据 HTTP 状态码动态调整日志级别(如 5xx 错误记为 SEVERE),有助于运维人员快速定位严重问题。这种策略在保证关键请求可追溯的同时,降低了日志存储成本和检索负担。



















