








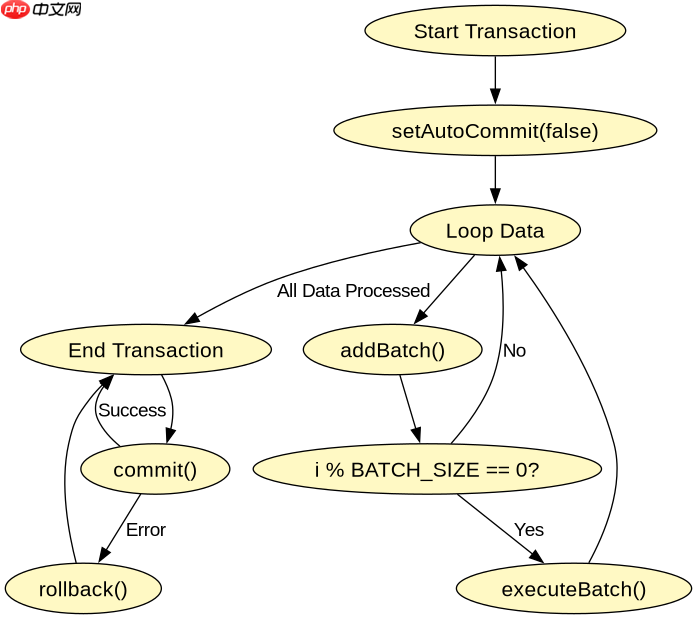
java preparedstatement 实现高可用批量数据写入的核心做法是:在事务中通过 addbatch() 积累 sql,使用 executebatch() 提交,并配合数据库连接池(如 hikaricp)和重试机制。具体而言,需设置 autocommit=false 以开启事务,将大批量数据拆分为固定大小的批次(例如每 1000 条执行一次),并在捕获异常时进行回滚或重试。这样做能显著减少网络往返次数,提升吞吐量,同时利用连接池保证连接的复用和高可用性。
如何配置连接池与事务管理
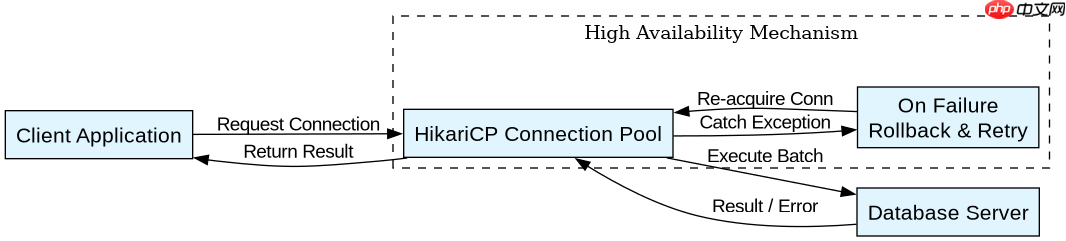
高可用的基础在于稳定的连接管理和正确的事务控制。开发者应使用 HikariCP 等现代连接池,并手动管理事务边界。关键步骤包括获取连接后关闭自动提交,设置隔离级别,以及确保在 finally 块中正确提交或回滚。这能防止连接泄漏和长事务锁表。
import com.zaxxer.hikari.HikariConfig;
import com.zaxxer.hikari.HikariDataSource;
import java.sql.Connection;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class BatchInsertExample {
    private static final String URL = "jdbc:mysql://localhost:3306/mydb";
    private static final String USER = "user";
    private static final String PASS = "password";
    private static final int BATCH_SIZE = 1000;

    public static void main(String[] args) {
        HikariConfig config = new HikariConfig();
        config.setJdbcUrl(URL);
        config.setUsername(USER);
        config.setPassword(PASS);
        config.setMaximumPoolSize(10);

        try (HikariDataSource dataSource = new HikariDataSource(config)) {
            insertBatch(dataSource);
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    private static void insertBatch(HikariDataSource dataSource) throws SQLException {
        String sql = "INSERT INTO users (name, email) VALUES (?, ?)";
        // 注意:try-with-resources 会自动关闭连接,但我们需要手动管理事务
        Connection conn = dataSource.getConnection();
        try {
            conn.setAutoCommit(false);
            PreparedStatement pstmt = conn.prepareStatement(sql);

            for (int i = 0; i < 5000; i++) {
                pstmt.setString(1, "User_" + i);
                pstmt.setString(2, "user_" + i + "@example.com");
                pstmt.addBatch();

                if (i % BATCH_SIZE == 0 && i > 0) {
                    pstmt.executeBatch();
                    pstmt.clearBatch();
                }
            }
            pstmt.executeBatch(); // 执行剩余部分
            conn.commit();
            System.out.println("Batch insert completed successfully.");
        } catch (SQLException e) {
            conn.rollback();
            throw e;
        } finally {
            conn.setAutoCommit(true); // 恢复默认状态
            conn.close();
        }
    }
}
预期结果:控制台输出 "Batch insert completed successfully.",数据库中插入 5000 条记录。若中途出错,则无数据插入(回滚)。
立即学习“Java免费学习笔记(深入)”;

如何处理批量插入中的异常与重试
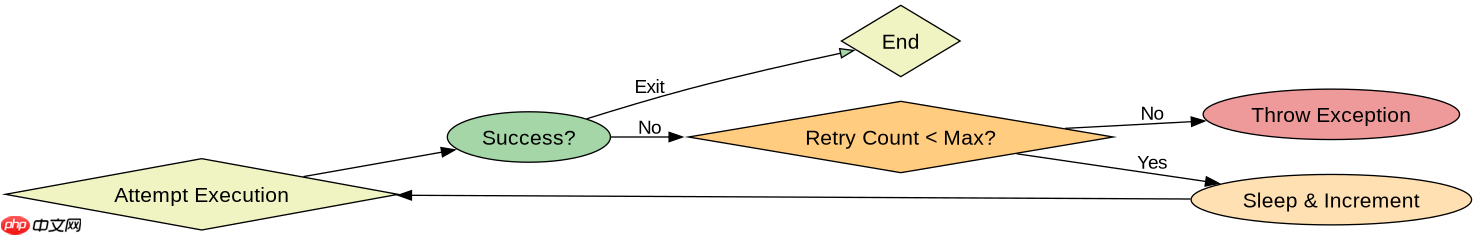
在高并发或网络不稳定环境下,批量插入可能因主键冲突、死锁或网络超时失败。应对策略包括:捕获特定异常(如 SQLIntegrityConstraintViolationException 或 SocketTimeoutException),对失败的批次进行局部重试或跳过。对于死锁,可短暂休眠后重试整个事务;对于唯一键冲突,可根据业务逻辑选择忽略或更新。这种容错机制确保了批量任务的高可用性。
import java.sql.*;
import java.util.concurrent.TimeUnit;

public class RetryableBatchInsert {
    private static final int MAX_RETRIES = 3;
    private static final long RETRY_DELAY_MS = 1000;

    public static void executeWithRetry(Connection conn, String sql, Object[][] batchData) throws SQLException, InterruptedException {
        PreparedStatement pstmt = null;
        int retryCount = 0;

        while (retryCount < MAX_RETRIES) {
            try {
                conn.setAutoCommit(false);
                pstmt = conn.prepareStatement(sql);

                for (Object[] data : batchData) {
                    for (int i = 0; i < data.length; i++) {
                        pstmt.setObject(i + 1, data[i]);
                    }
                    pstmt.addBatch();
                }

                pstmt.executeBatch();
                conn.commit();
                System.out.println("Success on attempt: " + (retryCount + 1));
                return; // 成功则退出

            } catch (SQLException e) {
                if (conn != null) conn.rollback();
                retryCount++;
                if (retryCount >= MAX_RETRIES) {
                    throw e;
                }
                System.out.println("Attempt failed, retrying... Error: " + e.getMessage());
                TimeUnit.MILLISECONDS.sleep(RETRY_DELAY_MS * retryCount); // 指数退避
            } finally {
                if (pstmt != null) pstmt.close();
                conn.setAutoCommit(true);
            }
        }
    }
}
预期结果:若前两次重试失败,第三次成功,则输出 "Success on attempt: 3"。若三次均失败,抛出异常。每次失败后会有延迟。
基于固定批次大小(BATCH_SIZE=1000)的内存与性能权衡问题
当设置 BATCH_SIZE=1000 时,程序会在内存中累积 1000 条语句后才执行一次 executeBatch()。这种做法平衡了内存占用和网络开销。如果批次太小(如 10),网络往返过多,性能低下;如果批次太大(如 10000),可能导致 OutOfMemoryError 或数据库端处理超时。1000 是一个经验值,适用于大多数 MySQL/PostgreSQL 场景,确保单批数据量在几 MB 以内,避免长时间持有数据库锁。



















