








在sql中利用join完成多对多关联表的扁平化提取,核心方法是使用inner join或left join将主表与中间关联表连接,再连接目标表,从而将原本分散在多行中的关系数据合并为单行记录。具体做法是确定主表、关联表和子表,通过外键字段进行等值连接,最终结果集的行数等于主表行数乘以关联表中该主表id对应的关联记录数。若需保留主表所有记录即使没有匹配项,应使用left join;若只关心有明确关联的数据,则使用inner join。
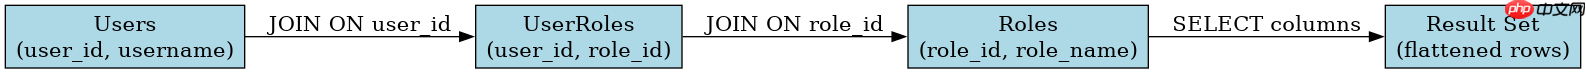
如何编写基础的多表JOIN查询语句
编写基础的多表JOIN查询语句时,需要明确指定连接条件和选择所需的列。通常从主表开始,依次JOIN关联表和子表,并使用ON子句定义连接逻辑。例如,从用户表JOIN到用户-角色关联表,再JOIN到角色表,可以获取每个用户的角色信息。这种写法直接反映了数据库的物理存储结构,便于理解数据的来源和流向。
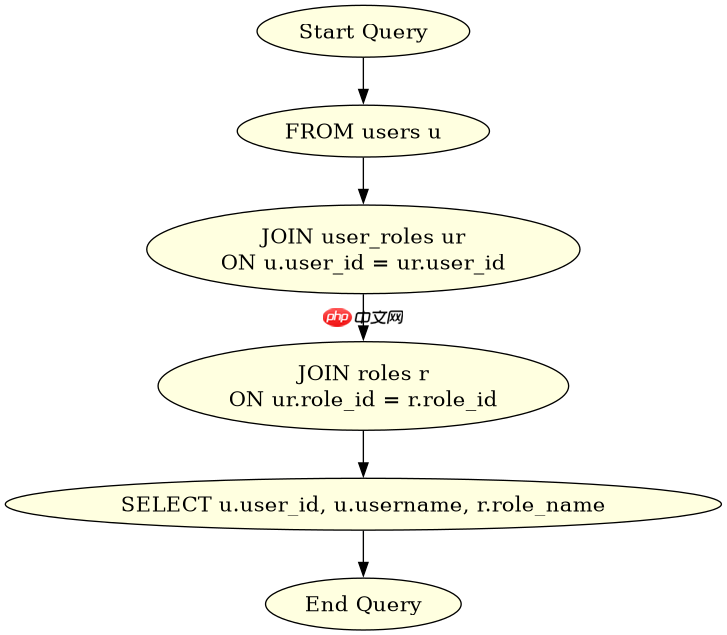
SELECT u.user_id, u.username, r.role_name
FROM users u
INNER JOIN user_roles ur ON u.user_id = ur.user_id
INNER JOIN roles r ON ur.role_id = r.role_id;
如何处理一对多关系导致的重复行问题
处理一对多关系导致的重复行问题时,关键在于理解JOIN产生的笛卡尔积效应。当主表的一条记录在关联表中有多条匹配记录时,JOIN操作会生成多条结果行。如果需要将这些多行合并为一行,可以使用聚合函数如GROUP_CONCAT或JSON_ARRAYAGG,配合GROUP BY子句来实现扁平化。这种方法适用于需要将多个关联值汇总到一个字段中的场景,避免了应用层的数据重组。
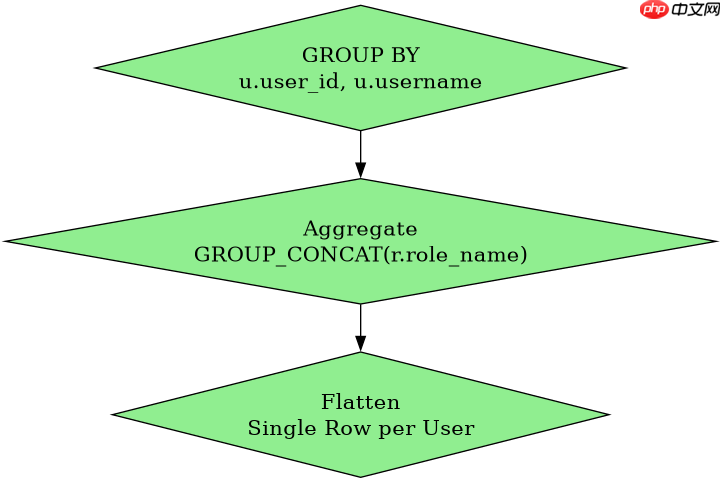
SELECT u.user_id, u.username, GROUP_CONCAT(r.role_name SEPARATOR ', ') AS roles
FROM users u
INNER JOIN user_roles ur ON u.user_id = ur.user_id
INNER JOIN roles r ON ur.role_id = r.role_id
GROUP BY u.user_id, u.username;
基于user_roles表中user_id为1的具体查询结果是什么
基于user_roles表中user_id为1的具体查询结果是获取该用户的所有关联角色名称。假设用户ID为1的用户在user_roles表中有两条记录,分别关联角色ID 101和102,那么在执行上述GROUP_CONCAT查询后,结果集中对应user_id为1的行,其roles字段将包含这两个角色的名称,以逗号分隔。这直接展示了多对多关联如何通过SQL查询被扁平化为单一字符串值,便于前端展示或进一步处理。

















