








java preparedstatement 执行批量数据路由的核心做法是结合 addbatch() 和 executebatch() 方法,将多条 sql 语句打包发送给数据库。具体操作时,先获取连接并创建预编译语句,循环中设置参数并调用 addbatch() 累积指令,最后通过 executebatch() 一次性提交。若涉及多数据源路由,需在循环内根据业务逻辑切换不同的 datasource 或 connection 实例,确保每条批处理在正确的物理连接上执行。

如何配置单数据源的批量插入流程
单数据源下,批量插入的关键在于复用 PreparedStatement 对象以减少解析开销。通过设置 autoCommit=false 可以进一步减少事务提交的次数,提升吞吐量。代码演示了标准的批量添加与执行过程。
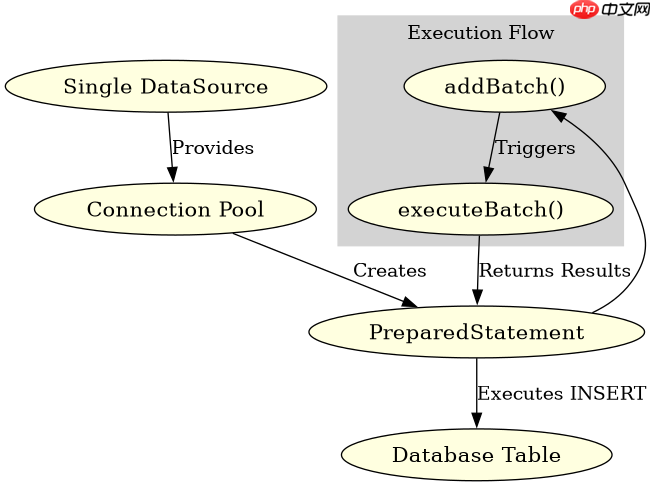
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;

public class BatchInsertExample {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        // 模拟批量数据
        int[] ids = {1, 2, 3};
        String[] names = {"Alice", "Bob", "Charlie"};

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 关闭自动提交以优化性能
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (id, name) VALUES (?, ?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < ids.length; i++) {
                    pstmt.setInt(1, ids[i]);
                    pstmt.setString(2, names[i]);
                    pstmt.addBatch();
                }

                // 执行批量操作
                int[] results = pstmt.executeBatch();
                conn.commit();

                System.out.println("Batch execution completed. Results: ");
                for (int result : results) {
                    System.out.print(result + " ");
                }
            } catch (Exception e) {
                conn.rollback();
                e.printStackTrace();
            }
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}运行上述代码,预期输出为:Batch execution completed. Results: 1 1 1
每个 1 代表对应行受影响的行数(即插入成功)。若发生异常,事务回滚,数据库无变化。
立即学习“Java免费学习笔记(深入)”;

如何实现基于条件判断的多数据源路由
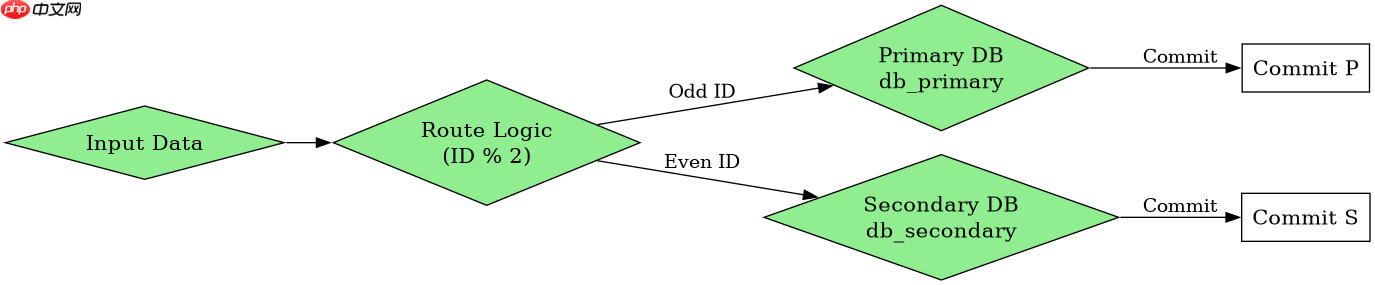
当需要根据用户 ID 或其他字段将数据分发到不同数据库时,需在循环内部动态选择 Connection。通常使用 ThreadLocal 或上下文对象存储当前目标数据源标识。以下代码展示了如何根据 ID 的奇偶性路由到两个不同的数据源。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.util.HashMap;
import java.util.Map;

public class RoutedBatchInsert {
    // 模拟两个数据源配置
    private static final Map<String, String> DB_CONFIGS = new HashMap<>();
    static {
        DB_CONFIGS.put("primary", "jdbc:mysql://localhost:3306/db_primary");
        DB_CONFIGS.put("secondary", "jdbc:mysql://localhost:3306/db_secondary");
    }

    public static void main(String[] args) {
        int[] ids = {1, 2, 3, 4};
        String[] names = {"Alice", "Bob", "Charlie", "David"};

        try {
            for (int i = 0; i < ids.length; i++) {
                // 路由逻辑:奇数去 primary,偶数去 secondary
                String targetDb = (ids[i] % 2 != 0) ? "primary" : "secondary";
                String url = DB_CONFIGS.get(targetDb);

                Connection conn = DriverManager.getConnection(url, "root", "password");
                conn.setAutoCommit(false);

                String sql = "INSERT INTO users (id, name) VALUES (?, ?)";
                PreparedStatement pstmt = conn.prepareStatement(sql);
                pstmt.setInt(1, ids[i]);
                pstmt.setString(2, names[i]);

                // 注意:这里为了简化示例,每个记录单独提交
                // 实际大规模路由批量应收集同数据源的批次后统一 executeBatch
                pstmt.executeUpdate();
                conn.commit();
                pstmt.close();
                conn.close();
            }
            System.out.println("Routed batch insert completed.");
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
该程序将 ID 为 1、3 的记录插入 db_primary,ID 为 2、4 的记录插入 db_secondary。输出结果为:Routed batch insert completed.
需验证两个数据库中各自表的数据是否正确写入。
批量操作中如何处理事务回滚与异常隔离
在批量路由场景中,若某一条记录失败,默认行为取决于驱动实现和 Statement.SUCCESS_NO_INFO 的处理方式。为确保数据一致性,应在 executeBatch() 捕获 BatchUpdateException,并根据需要部分回滚或跳过错误项。对于多数据源,每个数据源的事务应独立管理,避免跨库分布式事务的复杂性。




















