








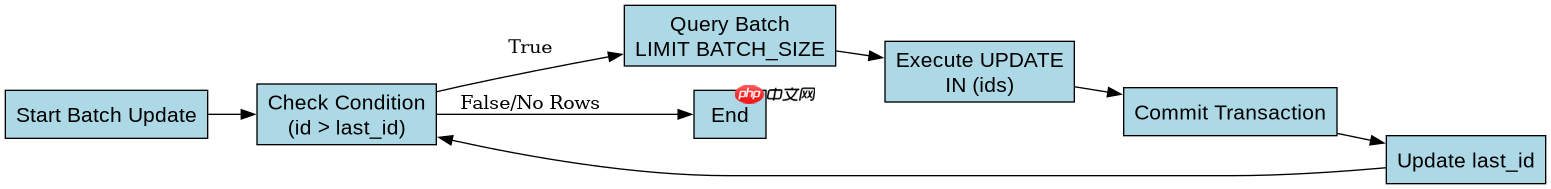
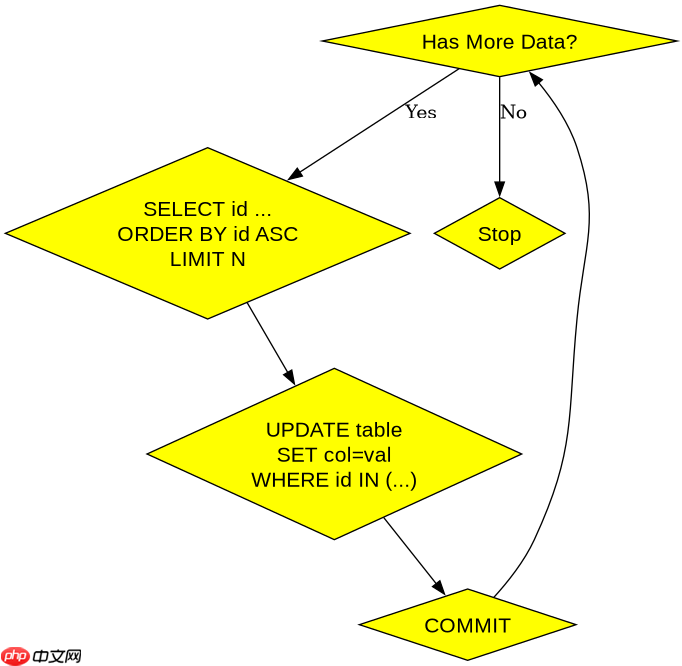
在大表更新场景下,分批update的核心做法是结合主键范围或唯一索引进行分片,每次只锁定少量行并立即提交。具体实现时,通过循环查询满足条件的最小id区间,执行update后提交事务,直到没有更多数据需要处理。这样做可以将长事务拆分为多个短事务,显著降低锁持有时间和死锁风险。
如何确定分批的边界条件
分批更新的边界条件通常基于主键(如 id)的范围。我们需要一个起始点(例如上次处理到的最大ID),并在每批中设定一个固定的批次大小(如 BATCH_SIZE)。查询语句应使用 WHERE id > last_max_id AND id 的形式,确保不重复处理且覆盖所有待更新记录。
import time

BATCH_SIZE = 1000
table_name = "large_table"
update_column = "status"
new_value = 1

# 假设初始状态为未处理,last_id 从 0 开始
last_id = 0

while True:
    # 1. 查询当前批次需要更新的记录ID
    query = f"SELECT id FROM {table_name} WHERE status != {new_value} AND id > {last_id} ORDER BY id ASC LIMIT {BATCH_SIZE}"
    rows = execute_query(query)

    if not rows:
        break

    ids = [row[0] for row in rows]
    max_id_in_batch = max(ids)

    # 2. 执行批量更新
    placeholders = ','.join(['%s'] * len(ids))
    update_sql = f"UPDATE {table_name} SET {update_column} = {new_value} WHERE id IN ({placeholders})"
    execute_update(update_sql, ids)

    # 3. 提交事务(关键:立即释放锁)
    commit_transaction()

    # 4. 更新游标
    last_id = max_id_in_batch

    # 可选:短暂休眠以避免对数据库造成过大压力
    time.sleep(0.1)
上述代码展示了基于主键范围的Python伪代码实现。关键点在于每次循环都开启新事务、执行更新、立即提交。这样确保了锁只在 commit() 前持有极短时间。预期结果是数据库负载平稳,无长时间锁等待。
如何处理并发冲突与重试机制
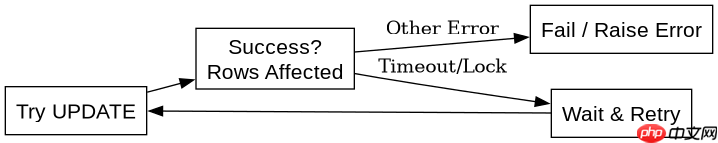
在高并发环境下,其他事务可能正在修改同一批数据,导致 UPDATE 影响行数少于预期或抛出锁超时异常。应对策略包括捕获特定异常(如 MySQL 的 Lock wait timeout exceeded)并进行重试。同时,应检查实际影响的行数,若为0则说明该批次已被其他事务处理,可跳过或重新查询。
import time
from mysql.connector import Error

MAX_RETRIES = 3
RETRY_DELAY = 1

def safe_update_batch(conn, batch_ids):
    for attempt in range(MAX_RETRIES):
        try:
            with conn.cursor() as cursor:
                placeholders = ','.join(['%s'] * len(batch_ids))
                sql = f"UPDATE large_table SET status = 1 WHERE id IN ({placeholders})"
                cursor.execute(sql, batch_ids)
                affected_rows = cursor.rowcount
                conn.commit()
                return affected_rows == len(batch_ids) or affected_rows > 0
        except Error as e:
            if 'Lock wait timeout' in str(e):
                time.sleep(RETRY_DELAY * (attempt + 1))
                continue
            else:
                raise
    return False

# 在主循环中调用
for ids in batch_ids_list:
    success = safe_update_batch(conn, ids)
    if not success:
        print(f"Failed to process batch: {ids}")
此代码增加了重试逻辑和异常处理。当遇到锁超时时,程序会等待并重试,而不是直接失败。这提高了在竞争环境下的鲁棒性。注意,重试次数不宜过多,以免无限期阻塞。
基于程序中某个输入、条件或结果的具体问题
在上述代码中,如果 execute_query 返回空列表,循环将终止。这意味着所有符合条件的记录都已处理完毕。这是一个明确的结束条件,避免了无限循环。开发者应确保初始查询能正确识别“未处理”状态,否则可能导致部分数据遗漏或重复处理。
















