








在postgresql中,使用 row_number() 窗口函数提取最新记录的核心做法是:在 over 子句中按时间戳降序排列并指定分区。具体实现时,需结合 case when 条件判断来筛选特定状态(如“已支付”)的最新数据,并通过子查询或cte过滤出排名为1的记录。此方法能确保即使存在多条符合条件的历史数据,也仅返回最近的一条。

如何按用户ID分组获取最新订单
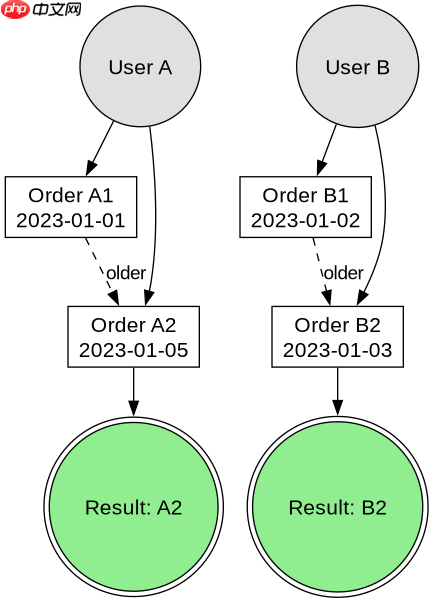
针对需要按用户维度提取最新订单的场景,直接对 order_id 排序即可。通过 PARTITION BY user_id 将数据分块,并按 created_at DESC 编号,排名为1的即为该用户的最新订单。若需处理并列时间戳,可追加 order_id DESC 作为次要排序键以保证结果确定性。
WITH ranked_orders AS (
    SELECT
        order_id,
        user_id,
        created_at,
        ROW_NUMBER() OVER (
            PARTITION BY user_id
            ORDER BY created_at DESC, order_id DESC
        ) as rn
    FROM orders
)
SELECT order_id, user_id, created_at
FROM ranked_orders
WHERE rn = 1;
预期结果:每个 user_id 对应一行记录,且为该用户创建时间最晚的订单。若某用户无订单,则不出现在结果集中。返回字段类型为 bigint (order_id), bigint (user_id), timestamptz (created_at)。
如何筛选特定状态的最新记录
当业务要求仅关注特定状态(例如 status = 'paid')的最新记录时,需在窗口函数计算前或后应用过滤。推荐做法是在CTE中先计算所有记录的排名,再在外层查询中同时满足 rn = 1 和 status = 'paid' 的条件。这样可避免因先过滤状态导致同一用户多条有效记录被错误截断的问题。

WITH ranked_paid_orders AS (
    SELECT
        order_id,
        user_id,
        status,
        created_at,
        ROW_NUMBER() OVER (
            PARTITION BY user_id
            ORDER BY created_at DESC
        ) as rn
    FROM orders
    WHERE status = 'paid'
)
SELECT order_id, user_id, created_at
FROM ranked_paid_orders
WHERE rn = 1;
预期结果:仅返回状态为“已支付”的用户最新订单。若某用户仅有“待支付”订单,则该用户不会出现在结果中。此写法效率高于先全量排序再过滤,因为 WHERE 子句在窗口函数执行前生效,减少了参与排名的数据量。
当时间戳相同时如何确定唯一记录
在数据库并发写入场景下,不同订单可能拥有完全相同的 created_at 值。此时若仅按时间戳排序,ROW_NUMBER() 的结果将不确定。为确保每次查询返回一致的唯一记录,必须在 ORDER BY 中引入唯一标识符(如 order_id)。通过附加 order_id DESC,系统会优先选择ID更大的记录,从而消除歧义并保证幂等性。

















