








在hive sql中优化由 row_number() 引发的数据倾斜,核心策略是打破导致数据倾斜的热点键(skew key)。具体做法是在执行窗口函数前,对产生倾斜的分组键进行加盐处理(salting),即给每个值附加一个随机后缀,将原本集中在单个reducer上的数据打散到多个节点并行计算。处理完成后,再去除后缀恢复原始键,最后重新聚合或排序得出最终结果。

如何识别并定位引发倾斜的Key
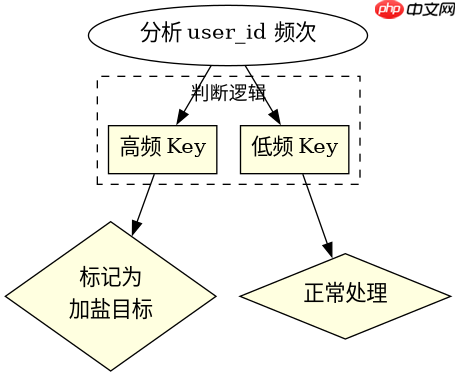
要解决倾斜问题,首先需要确认哪些 key 导致了数据分布不均。通常可以通过查看 Hive 任务的 Reduce 阶段日志,观察是否存在个别 Task 运行时间远超其他 Task 的情况。定位方法是在查询中加入统计逻辑,找出出现频率最高的 key,这些高频键就是需要加盐处理的对象。
-- 假设表名为 user_logs,倾斜字段为 user_id
-- 第一步:分析倾斜情况,找出 Top N 的热点用户
SELECT user_id, COUNT(*) as cnt
FROM user_logs
GROUP BY user_id
ORDER BY cnt DESC
LIMIT 10;
如果上述查询发现某些 user_id 的数据量占比极大,例如某个用户的日志量占总量的 50% 以上,那么直接对该字段使用 ROW_NUMBER() 就会导致该用户的所有数据被发送到同一个 Reducer,造成单点瓶颈。此时应将该 user_id 列表记录下来,作为后续加盐处理的黑名单或目标集合。
如何通过加盐算法实现负载均衡
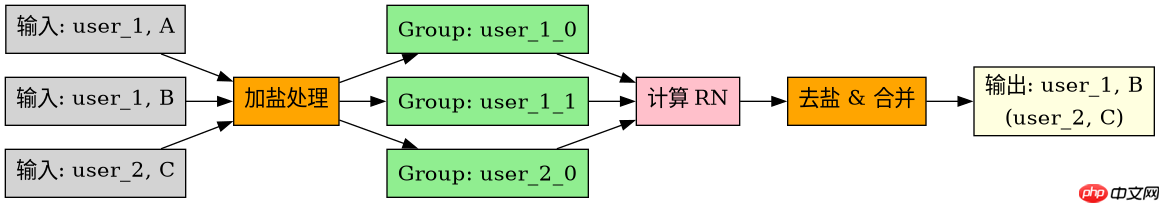
针对已识别的热点 key,采用“加盐-分散-去盐-合并”的四步法进行优化。首先,在原始数据上生成一个随机数(Salt),将其拼接到原 key 后形成新的复合键。这样,原本相同 key 的数据会被随机分配到不同的分区或 Reducer 中。接着,在这个新键空间内执行 ROW_NUMBER() 操作。由于数据已被打散,各个 Reducer 的负载将趋于均衡。最后,去除随机后缀,恢复原始 key,并根据业务需求进行二次聚合或排序。
-- 优化后的完整 SQL 示例
WITH salted_data AS (
    -- 1. 加盐:为每条记录添加一个 0-9 的随机后缀
    SELECT
        user_id,
        event_time,
        CONCAT(user_id, '_', CAST(RAND() * 10 AS INT)) AS salted_key
    FROM user_logs
),
salted_ranked AS (
    -- 2. 在加盐后的数据上计算 ROW_NUMBER
    SELECT
        user_id,
        event_time,
        ROW_NUMBER() OVER (PARTITION BY salted_key ORDER BY event_time DESC) as rn
    FROM salted_data
),
final_result AS (
    -- 3. 去盐:恢复原始 user_id
    SELECT
        user_id,
        event_time,
        rn
    FROM salted_ranked
)
-- 4. 最终筛选:取每个用户的第一条记录
SELECT
    user_id,
    event_time
FROM final_result
WHERE rn = 1;
这种写法虽然增加了中间步骤,但能有效避免单个 Reducer 内存溢出或任务超时。需要注意的是,RAND() 函数在 Hive 中每次调用都会生成不同的值,确保数据均匀分布。如果业务允许一定的近似性,也可以考虑使用 DISTRIBUTE BY 配合自定义分桶策略,但对于严格的 ROW_NUMBER() 排序去重,加盐法是标准且可靠的解决方案。
加盐后如何处理重复数据的去重逻辑
在使用加盐策略后,同一个 user_id 会在不同 Salt 值下产生多条记录,因此不能直接取最小或最大索引,而必须通过二次聚合来还原正确的 ROW_NUMBER 结果。具体来说,在去盐之后,我们需要再次基于原始 key 进行排序和编号,或者在加盐阶段就保留足够的信息以便后续合并。上述代码中的 final_result 部分展示了这一过程:先去盐,再根据 rn=1 筛选,但这仅适用于“取最新一条”的场景。若需更复杂的排序逻辑,建议在去盐后再次应用窗口函数,或者在加盐时保留原始行号,合并后再排序。
















