








queryselector 的性能取决于选择器的复杂度,简单 id 查询极快,但复杂 css 选择器会触发全量 dom 遍历导致性能瓶颈。优化核心是避免在循环或高频事件中重复调用该方法,改为缓存 dom 引用或使用 getelementbyid、getelementsbyclassname 等原生 api 替代。
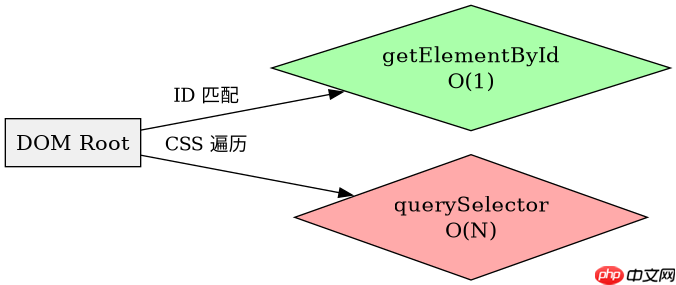
querySelector 遇到复杂选择器时为什么慢
当使用包含后代、伪类或属性匹配的选择器时,浏览器必须从根节点开始递归遍历整个 DOM 树以匹配规则。这种全量扫描的开销远高于直接通过 ID 获取元素,尤其在大型页面中会导致明显的渲染卡顿。
const list = document.querySelectorAll('.item');
for (let i = 0; i < list.length; i++) {
  const child = list[i].querySelector('.child');
  console.log(child);
}
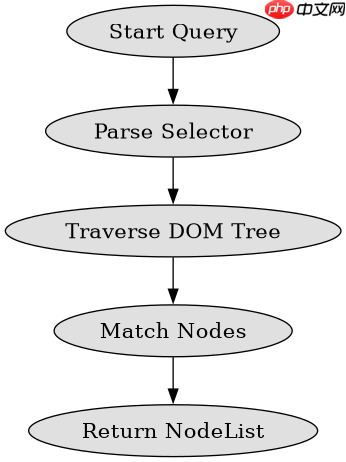
上述代码在每次循环中都执行了一次新的查询,若列表有 100 项,则产生 100 次独立的 DOM 遍历。实际运行中,这比先获取父容器再一次性查找子元素要慢得多。
立即学习“Java免费学习笔记(深入)”;

如何缓存引用以提升查询效率
将频繁访问的 DOM 节点存储在变量中,后续操作直接使用该变量而非重新查询。这种方式消除了重复的解析和遍历过程,显著降低 CPU 占用。

const container = document.getElementById('app');
const items = container.querySelectorAll('.item');
for (let i = 0; i < items.length; i++) {
  const child = items[i].querySelector('.child');
  console.log(child);
}
通过预先获取 container 和 items,循环内的查询范围被限制在局部子树中,大幅减少了搜索空间。对于仅需单个元素的场景,直接使用 getElementById 是最优解,因为它基于哈希表查找,时间复杂度为 O(1)。
在事件处理函数中重复查询会导致什么问题
如果在点击、滚动等高频事件中直接调用 querySelector,每次触发都会引发一次完整的 DOM 扫描。这不仅浪费计算资源,还可能因阻塞主线程而影响用户交互体验。
document.getElementById('btn').addEventListener('click', function() {
  const target = document.querySelector('.target');
  target.style.display = 'none';
});
该示例中,每次点击按钮都重新查询 .target。优化做法是在初始化阶段缓存该元素,事件处理中仅操作其属性,从而避免运行时查询开销。



















