








starlette 本身不直接解析 xml 请求数据,而是依赖底层的 asgi 服务器(如 uvicorn)或手动读取原始字节流。开发者需要在路由层通过 await request.body() 获取原始 xml 字符串,然后使用第三方库(如 xmltodict 或标准库 xml.etree.elementtree)将其转换为 python 字典或对象进行处理。
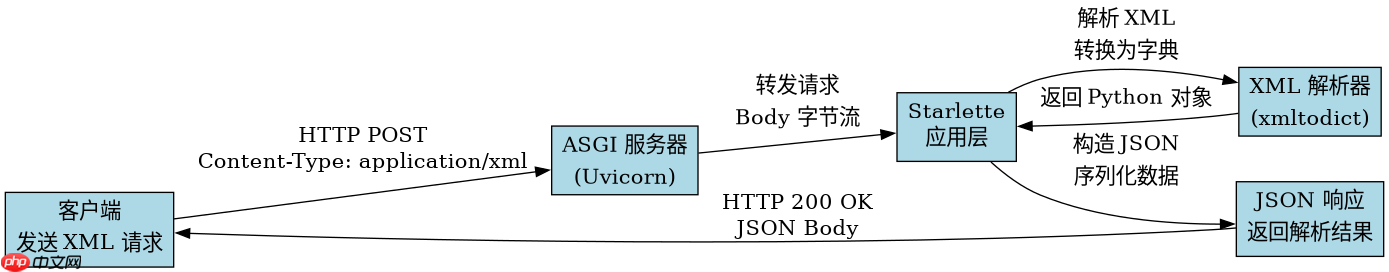
如何获取并解析XML原始数据
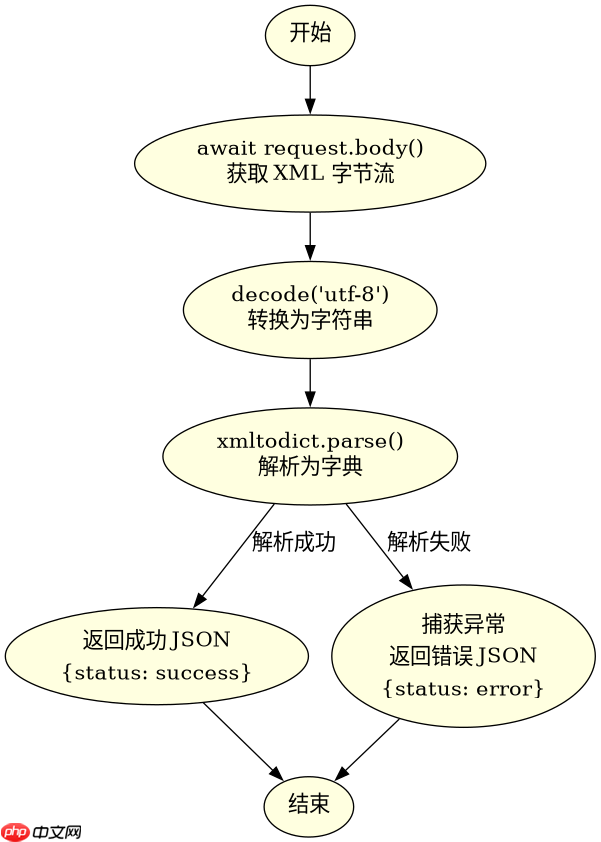
在 Starlette 中,处理 XML 的第一步是获取请求体。由于 Starlette 默认将 JSON 请求体缓存到 _body 属性中,但不会自动解析 XML,因此必须显式调用 request.body() 方法。该方法返回一个 bytes 对象,随后需要解码为字符串并使用 XML 解析器处理。以下代码展示了如何在路由中实现这一过程:
import xmltodict
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from starlette.routing import Route
from starlette.requests import Request

async def parse_xml(request: Request):
    # 1. 获取原始 XML 字节流
    body_bytes = await request.body()

    # 2. 解码为字符串
    xml_string = body_bytes.decode('utf-8')

    # 3. 使用 xmltodict 解析为字典
    try:
        data = xmltodict.parse(xml_string)
        return JSONResponse({"status": "success", "data": data})
    except Exception as e:
        return JSONResponse({"status": "error", "message": str(e)}, status_code=400)

app = Starlette(routes=[
    Route('/parse', parse_xml, methods=['POST'])
])
运行上述程序时,发送一个包含简单 XML 结构的 POST 请求,例如:<root><item id="1">Value</item></root>,预期输出为 JSON 格式的字典结构,其中键对应 XML 标签名,属性作为字典的键值对存储。若 XML 格式错误,则返回 400 状态码及错误信息。
如何处理XML中的属性和嵌套结构
当 XML 数据包含复杂嵌套或属性时,解析逻辑需特别注意层级关系。以 xmltodict 为例,它会将 XML 标签映射为字典键,属性存储在特殊键 @ 下,而文本内容则存储在 #text 键中。以下代码演示了如何提取嵌套 XML 中的特定字段:
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。

import xmltodict
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from starlette.routing import Route
from starlette.requests import Request

async def extract_nested_xml(request: Request):
    body_bytes = await request.body()
    xml_string = body_bytes.decode('utf-8')

    try:
        # 解析 XML
        parsed_data = xmltodict.parse(xml_string)

        # 假设 XML 结构为: <user><name>John</name><age>30</age></user>
        user_info = parsed_data.get('user', {})
        name = user_info.get('name')
        age = user_info.get('age')

        return JSONResponse({
            "name": name,
            "age": int(age) if age else None
        })
    except Exception as e:
        return JSONResponse({"error": str(e)}, status_code=400)

app = Starlette(routes=[
    Route('/extract', extract_nested_xml, methods=['POST'])
])
使用该程序时,输入如下 XML:<user><name>Alice</name><age>25</age></user>,预期输出为:{"name": "Alice", "age": 25}。若 XML 缺少 age 标签,则 age 字段值为 null。此示例验证了 xmltodict 对嵌套结构的处理方式,以及如何在 Starlette 路由中安全提取数据。
当XML根节点名称动态变化时如何处理
在实际场景中,XML 请求的根节点名称可能因业务逻辑而变化,例如用户提交的数据可能以 <profile></profile> 或 <settings></settings> 开头。此时,硬编码根节点名称会导致解析失败。解决方案是动态获取根节点名称,并基于该名称提取数据。以下代码展示了如何处理动态根节点的 XML:
import xmltodict
from starlette.applications import Starlette
from starlette.responses import JSONResponse
from starlette.routing import Route
from starlette.requests import Request

async def handle_dynamic_root(request: Request):
    body_bytes = await request.body()
    xml_string = body_bytes.decode('utf-8')

    try:
        parsed_data = xmltodict.parse(xml_string)

        # 动态获取根节点名称
        root_key = next(iter(parsed_data.keys()))
        root_data = parsed_data[root_key]

        return JSONResponse({
            "root_node": root_key,
            "content": root_data
        })
    except Exception as e:
        return JSONResponse({"error": str(e)}, status_code=400)

app = Starlette(routes=[
    Route('/dynamic', handle_dynamic_root, methods=['POST'])
])
使用该程序时,输入两种不同根节点的 XML:<profile><name>Bob</name></profile> 和 <settings><theme>dark</theme></settings>。预期输出分别为:{"root_node": "profile", "content": {"name": "Bob"}} 和 {"root_node": "settings", "content": {"theme": "dark"}}。此方法确保无论根节点名称如何变化,程序均能正确解析并返回数据。






















