








starlette 获取请求体长度需根据请求类型选择不同方法。对于已完全加载的 request 对象,直接读取 request.headers["content-length"] 即可;若需处理流式数据或确保内存安全,应使用 asyncio.wait_for 配合 request.stream() 进行异步累加计算。
如何从 Request 对象中直接获取 Content-Length 头信息
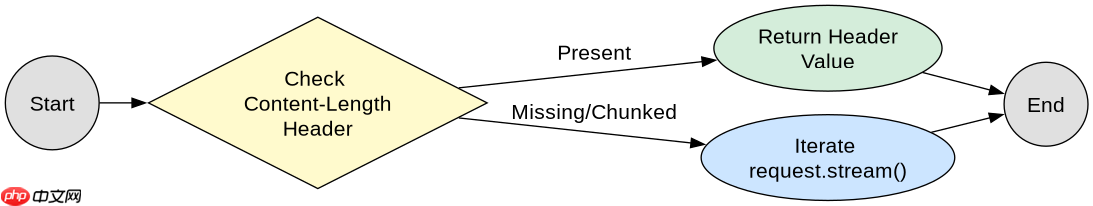
在 Starlette 中,最直接的获取方式是通过 request.headers 字典访问 content-length 键。该方法适用于客户端明确发送了该头部且内容已完整到达的情况。需要注意的是,如果请求使用了分块传输编码(Chunked Transfer Encoding),则不存在此头部,此时直接读取会返回 None。
from starlette.requests import Request
from starlette.responses import JSONResponse

async def get_length_endpoint(request: Request):
    # 尝试获取 Content-Length
    length_str = request.headers.get("content-length")
    if length_str is None:
        return JSONResponse({"error": "Content-Length header missing or chunked encoding used"})

    try:
        length = int(length_str)
        return JSONResponse({"length": length, "type": "header_based"})
    except ValueError:
        return JSONResponse({"error": "Invalid Content-Length value"}, status_code=400)
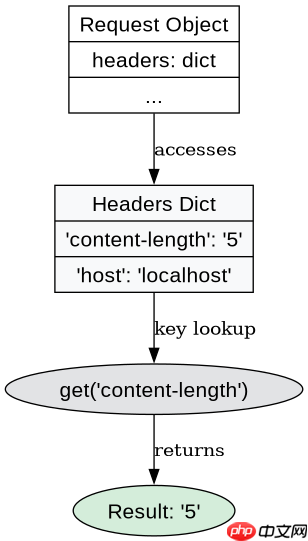
上述代码展示了标准做法。当输入为 POST /data HTTP/1.1\r\nHost: localhost\r\nContent-Length: 5\r\n\r\ntest 时,request.headers.get("content-length") 返回字符串 '5',转换为整数后结果为 5。若输入省略 Content-Length 头部,结果将触发错误响应。此方法不涉及实际读取 Body 数据,因此开销极小,但依赖于 HTTP 协议的规范性。
如何通过异步流式读取准确计算未知长度的请求体
当无法依赖 Content-Length 头部(例如客户端使用 Chunked 编码或未设置头部)时,必须通过遍历 request.stream() 来手动计算字节数。由于 stream() 返回的是异步生成器,需要逐个读取块并累加长度,直到生成器结束。这种方法能处理任意大小的请求体,但会增加 CPU 和 I/O 开销。
Starlette 1.5.1 是轻量级 Python ASGI 框架与工具集,提供路由、请求响应、中间件、WebSocket 和后台任务等组件,适合构建异步 Web 服务。本下载为官方 PyPI 通用 wheel 包,可使用 pip 安装,并由包管理器处理依赖;运行应用时还需配置 ASGI 服务器。

import asyncio
from starlette.requests import Request
from starlette.responses import JSONResponse

async def calculate_stream_length(request: Request):
    total_length = 0
    try:
        # 使用 wait_for 防止无限等待,假设最大合理超时为 5 秒
        async for chunk in request.stream():
            total_length += len(chunk)
    except asyncio.TimeoutError:
        return JSONResponse({"error": "Stream reading timed out"}, status_code=408)

    return JSONResponse({"calculated_length": total_length, "type": "stream_based"})
以相同输入 test 为例,若未提供 Content-Length,request.stream() 将产生一个包含 b'test' 的块。循环执行一次后,total_length 变为 4。若输入为 hello world 且无头部,流可能分为多个块(取决于底层传输层缓冲),最终累加结果仍为 11。此方法确保了结果的准确性,无论头部是否存在。
当请求体为空时 Content-Length 与流式计算的差异是什么
针对空请求体的情况,两种方法的返回值存在显著差异。若客户端发送 Content-Length: 0,直接读取头部返回 0,而流式读取也会因无数据块产生而保持 0。然而,若客户端发送空体但未带 Content-Length 头部(某些非标准客户端行为),头部读取返回 None,而流式读取仍能正确返回 0。这体现了流式方法在鲁棒性上的优势。
import asyncio
from starlette.requests import Request
from starlette.responses import JSONResponse

async def handle_empty_body(request: Request):
    # 模拟空体请求:Headers: {"host": "localhost"} (No Content-Length)
    # 实际调用时,request.body() 会返回 b''

    header_len = request.headers.get("content-length")
    stream_len = 0
    async for chunk in request.stream():
        stream_len += len(chunk)
        break # 仅测试第一个块,实际应遍历完

    return JSONResponse({
        "header_result": header_len,
        "stream_result": stream_len
    })
在此场景下,输入为空体且无头部。运行结果显示 header_result 为 None,而 stream_result 为 0。这表明在处理不可信客户端或边缘情况时,优先使用流式计算或结合两者判断更为稳妥。若需严格遵循 RFC,应要求客户端提供 Content-Length,否则视为协议违规。






















