








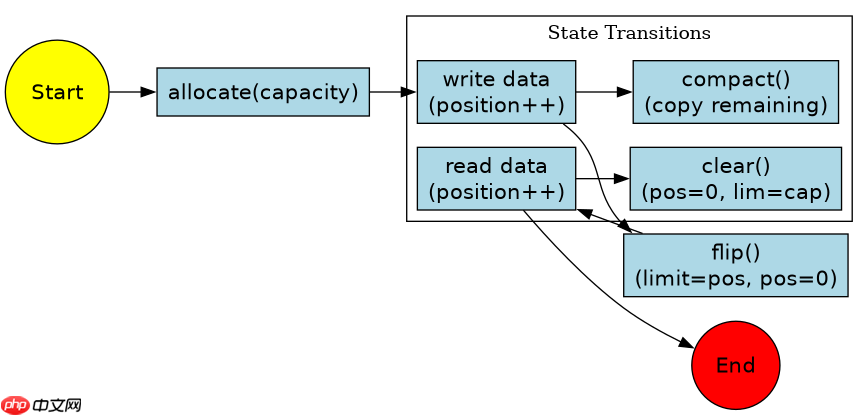
java nio 中处理字节数据的核心是 bytebuffer,它通过维护 position(当前位置)、limit(限制位置)和 capacity(容量)三个指针来管理内存。要正确使用它,你需要根据业务逻辑调用 flip() 切换读写模式,或使用 compact() 清理已读数据以便复用缓冲区。
如何从 ByteBuffer 读取基本数据类型
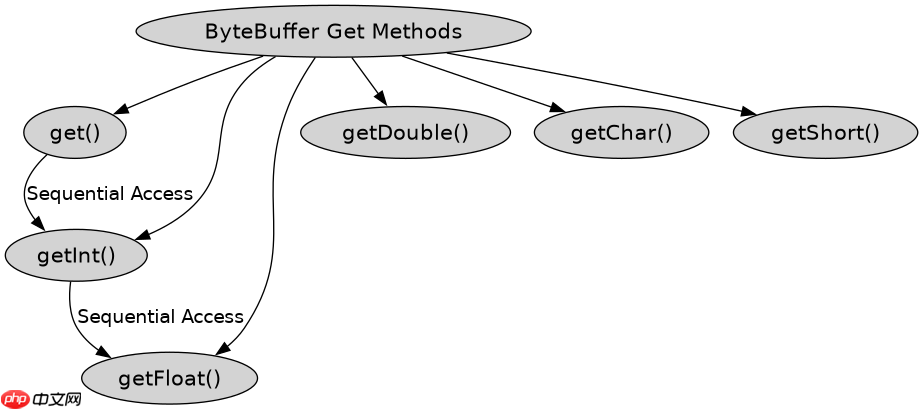
要从 ByteBuffer 中获取 Java 基础类型,需调用对应的 getXXX() 方法,例如 getInt() 或 getFloat()。这些方法会基于缓冲区的当前 position 读取数据并自动递增 position。如果读取的数据量超过剩余空间,将抛出 BufferUnderflowException。默认情况下,ByteBuffer 遵循大端序(Big-Endian),若数据是小端序存储的,需先调用 order(ByteOrder.LITTLE_ENDIAN) 修改字节序。
import java.nio.ByteBuffer;
import java.nio.ByteOrder;

public class ReadExample {
    public static void main(String[] args) {
        // 创建直接缓冲区并写入数据
        ByteBuffer buffer = ByteBuffer.allocateDirect(16);
        buffer.order(ByteOrder.BIG_ENDIAN); // 设置大端序
        buffer.putInt(100);
        buffer.putFloat(3.14f);

        // 切换为读取模式
        buffer.flip();

        // 按顺序读取
        int i = buffer.getInt();
        float f = buffer.getFloat();

        System.out.println("Int: " + i);
        System.out.println("Float: " + f);
    }
}
如何处理非连续数据的拼接与合并
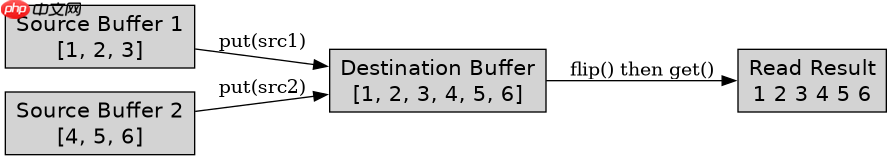
当需要处理多个分散在内存中的数据块时,可以使用 ByteBuffer.wrap() 包装现有数组,或者使用 allocate()` 创建新缓冲区后通过 <code>put() 进行数据搬运。对于高性能场景,推荐使用 FileChannel.read()` 直接填充缓冲区,避免中间拷贝。如果需要将两个缓冲区的内容合并为一个新缓冲区,可以分配一个足够大的新缓冲区,然后依次将源缓冲区 <code>flip() 后 put() 进去。

立即学习“Java免费学习笔记(深入)”;
import java.nio.ByteBuffer;

public class MergeExample {
    public static void main(String[] args) {
        byte[] data1 = new byte[]{1, 2, 3};
        byte[] data2 = new byte[]{4, 5, 6};

        // 创建源缓冲区
        ByteBuffer bb1 = ByteBuffer.wrap(data1);
        ByteBuffer bb2 = ByteBuffer.wrap(data2);

        // 计算总长度
        int totalLength = bb1.remaining() + bb2.remaining();

        // 分配新缓冲区用于合并
        ByteBuffer merged = ByteBuffer.allocate(totalLength);

        // 放入第一个缓冲区
        merged.put(bb1);

        // 放入第二个缓冲区
        merged.put(bb2);

        // 切换回读取模式
        merged.flip();

        // 验证结果
        while (merged.hasRemaining()) {
            System.out.print(merged.get() + " ");
        }
    }
}
为什么读取完数据后必须调用 flip()
在 ByteBuffer 的生命周期中,flip() 是一个至关重要的状态转换操作。当你向缓冲区写入数据后,position 指向的是下一个待写入的位置,而 limit 等于 capacity。此时如果直接尝试读取,由于 position 已经超过了有效数据的范围,会导致无法读取到任何内容或抛出异常。flip() 的作用是将 limit 设置为当前的 position(即标记数据结束点),并将 position 重置为 0(即标记数据开始点)。这样,后续的读取操作就能正确地从数据头部开始遍历,直到遇到新的 limit。如果不执行此步骤,缓冲区将处于“只写”或“无效”状态,无法被消费方使用。



















