








在 java 中,使用异常链保留原始错误信息的核心做法是在构造自定义异常时,将捕获到的原始异常作为参数传递给父类构造函数。这样可以在抛出新的业务异常时,通过 getcause() 方法获取到原始的堆栈跟踪和错误详情,从而在不丢失上下文的情况下进行错误处理或日志记录。

如何构建带异常链的自定义异常
要构建一个支持异常链的自定义异常,需要继承 Exception 或其子类,并提供接受 Throwable 参数的构造函数。在构造函数内部,调用 super(message, cause) 即可建立链接。这种做法确保了当新异常被抛出时,原始异常的完整信息(包括行号和类名)都被保留下来,方便后续排查问题。
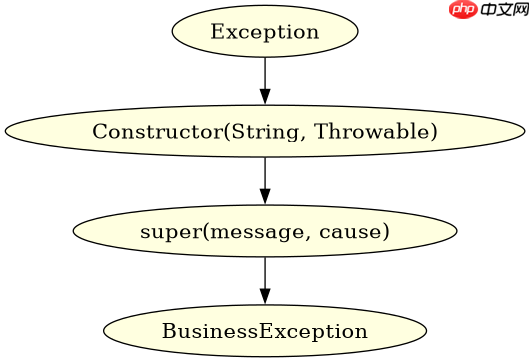
public class BusinessException extends Exception {
    public BusinessException(String message, Throwable cause) {
        super(message, cause);
    }
}
上述代码定义了一个简单的 BusinessException,它允许在实例化时传入原始异常对象。在实际使用中,开发者只需在 catch 块中捕获底层异常,并包装成该业务异常抛出即可。
立即学习“Java免费学习笔记(深入)”;

如何在运行时访问原始异常信息
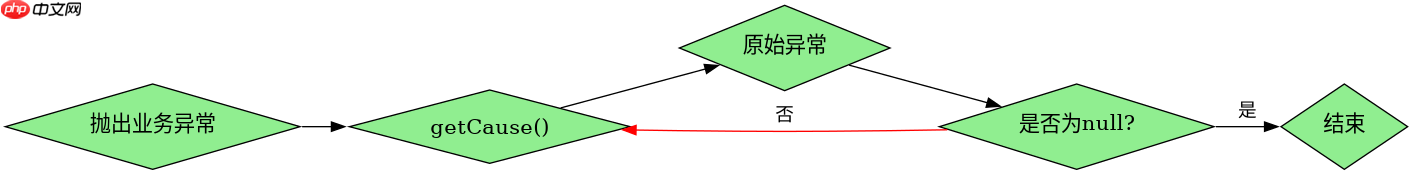
当异常链被抛出后,可以通过调用异常对象的 getCause() 方法来获取原始异常。如果原始异常本身也有原因,可以递归调用直到返回 null。此外,打印堆栈跟踪时,Java 默认会展示整个链式结构,使得调试更加直观。
try {
    // 模拟可能抛出 RuntimeException 的操作
    throw new RuntimeException("Database connection failed");
} catch (RuntimeException e) {
    BusinessException be = new BusinessException("Operation failed", e);
    System.out.println(be.getCause().getMessage()); // 输出: Database connection failed
    be.printStackTrace();
}
运行上述代码,控制台会输出原始异常的消息,并且 printStackTrace() 会显示从业务异常到原始异常的完整调用路径。这种机制保证了错误信息的完整性,避免了因异常转换而丢失关键调试数据。
异常链中的嵌套深度对性能有何影响
虽然异常链提供了强大的调试能力,但过深的嵌套可能会导致内存占用增加和堆栈跟踪打印变慢。在极端情况下,如果异常链非常长,printStackTrace() 的执行时间会显著增加。因此,建议在业务逻辑中保持合理的异常层级,避免无意义的多层包装。



















