








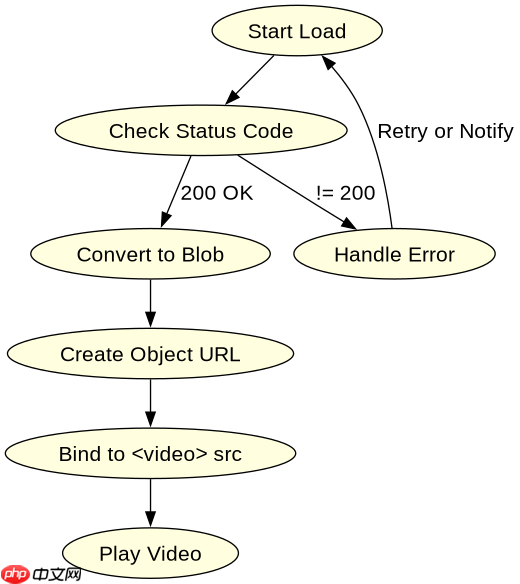
使用 fetch 获取 m4v 数据时,应调用 response.blob() 方法将响应体转换为二进制 blob 对象,随后通过 url.createobjecturl() 生成临时 url 并赋值给视频元素的 src 属性。此方法避免了手动处理 arraybuffer 的繁琐步骤,直接利用浏览器原生能力解码流媒体数据。若需支持断点续传或大文件分片加载,则需结合 range 请求头与 readablestream 进行更精细的控制。

如何获取并播放完整的 M4V 视频流
对于大多数场景,直接下载完整资源是最简单的方案。通过发起标准 GET 请求,获取包含视频数据的 Blob,即可在页面上实现即时播放。关键在于确保服务器正确设置了 Content-Type 为 video/mp4 或 video/x-m4v,否则浏览器可能无法识别格式。
const videoUrl = 'https://example.com/video.m4v';

fetch(videoUrl)
  .then(response => {
    if (!response.ok) {
      throw new Error('Network response was not ok');
    }
    return response.blob();
  })
  .then(blob => {
    const objectUrl = URL.createObjectURL(blob);
    const videoElement = document.getElementById('myVideo');
    videoElement.src = objectUrl;

    // 可选:当不再需要时释放内存
    // videoElement.onended = () => URL.revokeObjectURL(objectUrl);
  })
  .catch(error => console.error('Fetch error:', error));
上述代码首先检查 HTTP 状态码,确保请求成功。接着将响应体转换为 Blob 对象,该对象包含了原始的 M4V 字节流。最后,创建对象 URL 并绑定到 HTML5 <video></video> 标签上,浏览器会自动解析该 URL 并开始缓冲和播放视频。整个过程无需额外库支持,完全依赖原生 API。
立即学习“Java免费学习笔记(深入)”;

如何实现 M4V 视频的分片加载(Seeking)
当视频文件较大或网络不稳定时,全量加载会导致首屏延迟过高。此时应利用 HTTP Range 请求头,仅请求视频流的特定字节范围。M4V 基于 MP4 容器结构,支持随机访问,因此可以只下载关键帧所在的片段以快速预览,后续再按需加载其余部分。这需要解析视频元数据以确定各片段的偏移量,或者简单地按固定大小切分。

const videoUrl = 'https://example.com/large_video.m4v';
const chunkSize = 1024 * 1024; // 1MB per chunk
let loadedChunks = new Set();

function loadChunk(start, end) {
  const headers = new Headers();
  headers.append('Range', `bytes=${start}-${end}`);

  return fetch(videoUrl, { headers })
    .then(response => {
      if (response.status === 206) {
        return response.arrayBuffer();
      } else {
        throw new Error(`Failed to load chunk: ${response.status}`);
      }
    });
}

// 示例:加载第一个 1MB 用于快速预览
loadChunk(0, chunkSize - 1)
  .then(buffer => {
    const blob = new Blob([buffer], { type: 'video/mp4' });
    const url = URL.createObjectURL(blob);
    const video = document.getElementById('seekableVideo');
    video.src = url;
    video.play();
  })
.catch(err => console.error(err));在分片加载场景中,fetch 必须配合自定义 Headers 对象发送 Range 字段。服务器返回 206 Partial Content 状态码及对应的字节块。客户端将这些块合并或直接播放当前可用的块。需要注意的是,MP4/M4V 文件头通常位于文件起始处,包含 moov atom,因此至少需要下载前几 KB 才能被播放器正确识别。后续 seek 操作可能需要动态加载其他范围的 chunk,这通常需要更复杂的逻辑来管理缓冲区。
如果服务器未返回正确的 Content-Type 会发生什么
当服务器配置错误,未将 M4V 文件的 MIME 类型设置为 video/mp4 而是返回 application/octet-stream 或其他类型时,浏览器的视频播放器可能拒绝初始化解码器。此时,即使通过 blob() 成功获取了二进制数据,<video></video> 元素也可能显示黑屏或报错 MediaError。解决方法是在前端强制指定类型,或在后端修正配置。
// 假设 response.headers.get('content-type') 返回 'application/octet-stream'
fetch(videoUrl)
  .then(response => {
    return response.blob().then(blob => {
      // 强制创建类型为 video/mp4 的 Blob
      const correctBlob = new Blob([blob], { type: 'video/mp4' });
      const url = URL.createObjectURL(correctBlob);
      document.getElementById('myVideo').src = url;
    });
  });
通过构造新的 Blob 并显式传入 { type: 'video/mp4' },可以覆盖原始响应中的 MIME 类型信息。这使得浏览器忽略服务器的错误声明,尝试使用 MP4 解码器进行处理。这是一种有效的降级策略,但前提是视频数据本身符合 MP4 规范。如果数据损坏或格式不符,此方法无效。
















