








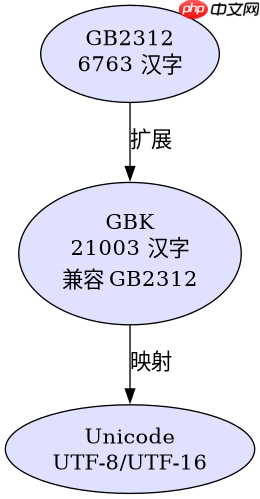
gbk 是 gbk 编码,全称为 chinese internal code specification,它是 gb2312 的扩展,主要用于在 windows 系统中表示简体中文。它向下兼容 gb2312,支持更多的汉字和符号,包括繁体中文、日文假名等。在 java 中,可以通过 new string(bytes, "gbk") 或 standardcharsets.gbk(java 7+)来指定使用 gbk 编码进行字符解码。
GBK 与 GB2312 的区别是什么
GBK 是 GB2312 的超集,主要区别在于字符集的大小和兼容性。GB2312 仅包含 6763 个常用汉字,而 GBK 扩展到了 21003 个汉字,并增加了对繁体字、日文假名等的支持。GBK 完全兼容 GB2312,即 GB2312 的字符在 GBK 中的编码方式不变。在 Java 中,处理 GBK 编码时,需要注意其双字节特性,尤其是当遇到非 ASCII 字符时,需要正确识别双字节序列。

import java.nio.charset.StandardCharsets;

public class GbkExample {
    public static void main(String[] args) {
        String text = "你好";
        try {
            byte[] gbkBytes = text.getBytes("GBK");
            System.out.println("GBK bytes: " + new String(gbkBytes, StandardCharsets.ISO_8859_1));
            String decoded = new String(gbkBytes, "GBK");
            System.out.println("Decoded: " + decoded);
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}
GBK 编码中一个汉字占几个字节
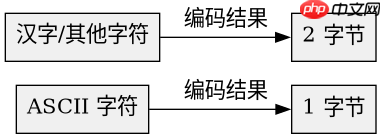
在 GBK 编码中,一个汉字通常占用两个字节。这是因为 GBK 是一种双字节编码方案,每个汉字由两个字节组成。对于 ASCII 字符(如英文字母),GBK 仍然使用单字节表示,以保持与 ASCII 的兼容性。在 Java 中,当使用 getBytes("GBK") 方法时,返回的字节数组长度会根据字符的不同而变化:ASCII 字符为 1 字节,汉字为 2 字节。
立即学习“Java免费学习笔记(深入)”;
import java.nio.charset.StandardCharsets;

public class GbkByteSize {
    public static void main(String[] args) {
        String text = "A你B好";
        try {
            byte[] gbkBytes = text.getBytes("GBK");
            System.out.println("Total bytes: " + gbkBytes.length);
            for (int i = 0; i < gbkBytes.length; i++) {
                System.out.print(gbkBytes[i] + " ");
            }
            System.out.println();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }
}



















