








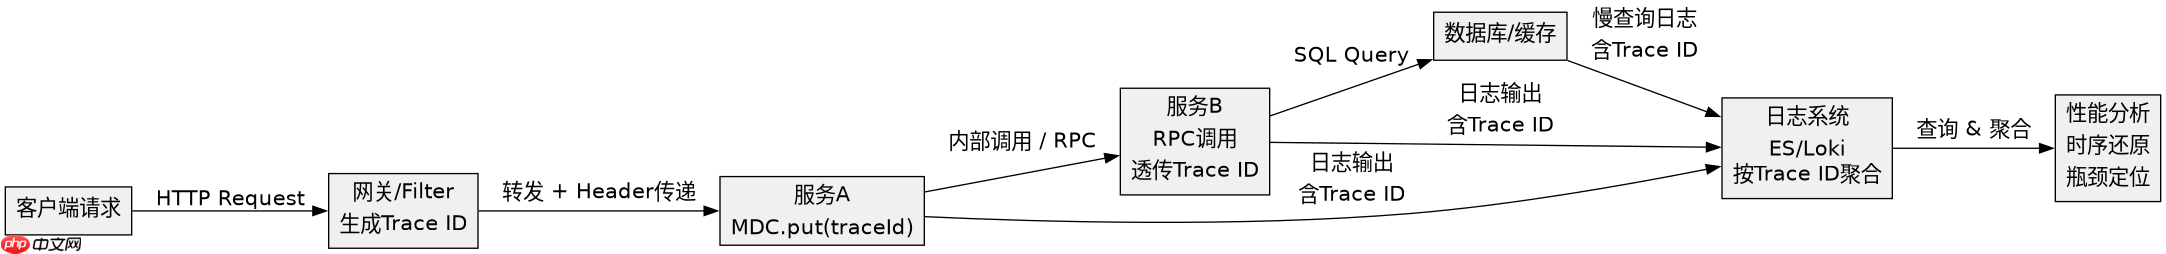
通过日志链路分析优化性能的核心做法是引入分布式追踪id(trace id)并在日志中透传,从而将分散在不同服务或线程中的日志串联起来。具体实现时,需在入口生成唯一id并放入mdc(mapped diagnostic context),在业务逻辑和rpc调用中自动传递该id,最后利用elk等工具按trace id聚合日志。这样做能直接定位耗时瓶颈、排查并发冲突及异步任务异常,显著降低问题排查时间。
如何在代码中实现Trace ID的自动透传?
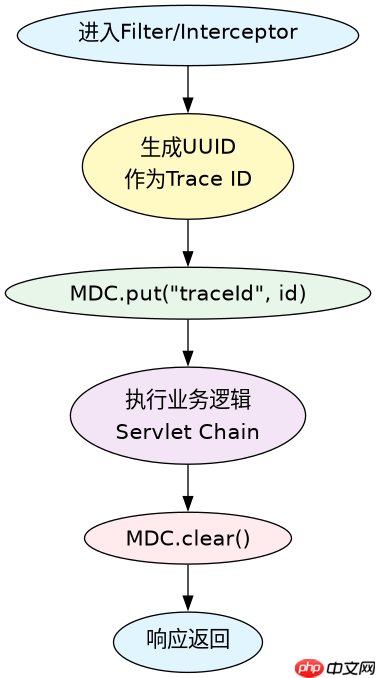
在Java应用中实现Trace ID透传,最标准且低侵入的方式是利用SLF4J的MDC机制结合拦截器或过滤器。对于Web应用,通常在Filter或Interceptor中生成UUID作为Trace ID,并将其put到MDC中;对于多线程场景,需使用TransmittableThreadLocal (TTL) 来确保子线程能继承父线程的MDC数据。这样配置后,所有由该线程产生的日志都会自动携带该ID,无需在每个方法签名中手动传递参数。
import org.slf4j.MDC;
import java.util.UUID;

public class TraceIdFilter implements Filter {
    @Override
    public void doFilter(ServletRequest request, ServletResponse response, FilterChain chain) {
        // 1. 生成唯一的Trace ID
        String traceId = UUID.randomUUID().toString().replace("-", "");
        try {
            // 2. 将Trace ID放入MDC,后续日志框架会自动读取
            MDC.put("traceId", traceId);
            // 3. 执行后续逻辑
            chain.doFilter(request, response);
        } finally {
            // 4. 清理MDC,防止内存泄漏或数据污染
            MDC.clear();
        }
    }
}
上述代码展示了基础的Web层透传逻辑。若涉及线程池,需替换为`TtlMdcAdapter`等支持线程上下文传递的工具类,否则子线程日志中将无法获取Trace ID。配合Logback或Log4j2的配置,在Pattern Layout中加入`%X{traceId}`即可在日志输出中看到该ID。
立即学习“Java免费学习笔记(深入)”;

如何利用Trace ID进行具体的性能瓶颈分析?
拿到带有Trace ID的日志后,性能分析的关键在于“聚合”与“时序还原”。在ELK(Elasticsearch, Logstash, Kibana)或Loki等日志系统中,以Trace ID为查询条件,可以拉取该请求全生命周期的所有日志。通过分析日志中的时间戳差值,可以计算出各个组件(如Controller、Service、DAO、外部RPC)的处理耗时。例如,若发现某次请求总耗时5秒,但数据库查询日志显示仅耗时10ms,而中间存在大量“等待连接”或“GC停顿”相关的日志,则瓶颈不在SQL本身,而在资源调度或JVM状态。

// 模拟一个包含多个步骤的业务方法,用于演示日志关联
@Service
public class OrderService {
    private static final Logger log = LoggerFactory.getLogger(OrderService.class);

    public void createOrder(String orderId) {
        // 假设Trace ID已在MDC中
        log.info("开始创建订单: {}", orderId);

        long start = System.currentTimeMillis();
        try {
            // 步骤1:校验库存
            checkInventory(orderId);
            log.info("库存校验完成, 耗时: {}ms", System.currentTimeMillis() - start);

            // 步骤2:扣减库存(可能涉及RPC)
            deductStock(orderId);
            log.info("库存扣减完成, 耗时: {}ms", System.currentTimeMillis() - start);

            // 步骤3:生成订单记录
            saveOrder(orderId);
            log.info("订单保存完成, 总耗时: {}ms", System.currentTimeMillis() - start);
        } catch (Exception e) {
            log.error("订单创建失败, traceId: {}, error: {}", MDC.get("traceId"), e.getMessage());
            throw e;
        }
    }

    private void checkInventory(String id) { /* ... */ }
    private void deductStock(String id) { /* ... */ }
    private void saveOrder(String id) { /* ... */ }
}
在实际运行中,观察上述代码生成的日志序列。如果`deductStock`阶段的日志间隔远大于预期,且伴随有数据库慢查询日志,则说明该RPC调用或DB操作是瓶颈。通过Trace ID将这些离散的日志点串联成一条完整的时间线,开发者可以精确到毫秒级地定位性能损耗点,而不是盲目猜测。
当Trace ID缺失或断裂时如何排查异步任务问题?
在基于消息队列(如Kafka、RabbitMQ)或异步线程池的场景中,Trace ID最容易丢失。如果消费者日志中没有Trace ID,或者ID与生产者不一致,会导致链路断裂,无法进行端到端的性能分析。解决此问题的关键在于生产者在发送消息时将Trace ID写入Header或Payload,消费者在消费时提取该ID并重新注入MDC。若未正确配置,日志中将出现“null”或空值,此时需检查线程池包装器是否继承了上下文。
// 生产者端:将Trace ID放入消息头
public void sendMessage(String message) {
    String traceId = MDC.get("traceId");
    MessageProperties props = new MessageProperties();
    if (traceId != null) {
        props.setHeader("X-Trace-Id", traceId);
    }
    template.send(new Message(message.getBytes(), props));
}

// 消费者端:从消息头提取并注入MDC
@RabbitListener(queues = "myQueue")
public void receiveMessage(Message message) {
    String traceId = (String) message.getMessageProperties().getHeader("X-Trace-Id");
    if (traceId == null) {
        traceId = UUID.randomUUID().toString().replace("-", "");
    }
    MDC.put("traceId", traceId);
    try {
        // 处理业务逻辑
        process(message.getBody());
    } finally {
        MDC.clear();
    }
}
通过这种显式的Header传递与MDC注入,确保了即使经过异步跳板,Trace ID依然连贯。若发现日志中Trace ID突然变为新ID,说明在该节点发生了上下文丢失,需重点检查该节点的线程模型和日志框架配置。




















