








优化 java hashset 性能的核心在于减少哈希冲突和避免扩容带来的开销,最直接的做法是在初始化时指定合适的初始容量(initial capacity)和负载因子(load factor)。通过根据预期元素数量计算并设置初始容量,可以确保 hashset 在添加元素时极少触发 resize 操作,从而将时间复杂度稳定在 o(1)。此外,确保存入 hashset 的对象正确重写了 hashcode 和 equals 方法也是防止逻辑冲突、保证查询准确性的基础前提。
如何计算合适的初始容量以避免扩容
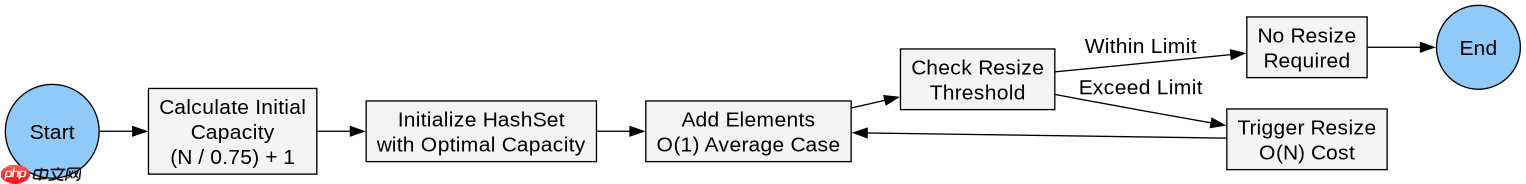
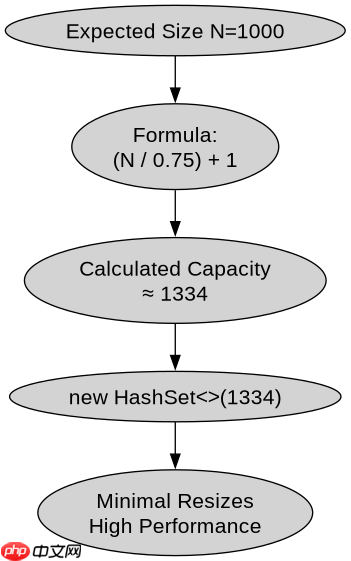
要避免 HashSet 在运行过程中因容量不足而进行昂贵的扩容操作,必须在创建实例时传入预期的元素数量。HashSet 的底层实现依赖于 HashMap,其扩容阈值由 initialCapacity * loadFactor 决定。默认负载因子为 0.75,这意味着如果未指定容量,当元素数量达到 12 个(假设默认初始容量 16)时就会触发扩容。正确的做法是根据业务场景预估的最大元素数 N,利用公式 (N / 0.75) + 1 计算出所需的桶数组大小,并将其作为构造函数参数传入。这样能确保在添加所有预期元素后,最多只发生一次扩容甚至零次扩容,显著提升批量插入的性能。
import java.util.HashSet;
import java.util.Set;

public class HashSetOptimization {
    public static void main(String[] args) {
        // 假设我们需要存储 1000 个不重复的元素
        int expectedSize = 1000;

        // 错误做法:使用默认构造函数,初始容量为 16,负载因子 0.75
        // 会在添加过程中多次触发扩容,导致性能下降
        Set<String> badSet = new HashSet<>();

        // 正确做法:根据预期大小计算初始容量
        // 公式:(expectedSize / loadFactor) + 1
        // 这里 loadFactor 默认为 0.75
        int optimalCapacity = (int) (expectedSize / 0.75f) + 1;
        Set<String> goodSet = new HashSet<>(optimalCapacity);

        long start = System.currentTimeMillis();
        for (int i = 0; i < expectedSize; i++) {
            goodSet.add("Element_" + i);
        }
        long end = System.currentTimeMillis();

        System.out.println("Added " + goodSet.size() + " elements in " + (end - start) + " ms");
        System.out.println("Actual capacity: " + getCapacity(goodSet));
    }

    // 反射获取 HashSet 内部 HashMap 的 table 长度
    private static int getCapacity(Set<String> set) throws Exception {
        java.lang.reflect.Field field = set.getClass().getDeclaredField("map");
        field.setAccessible(true);
        Object map = field.get(set);
        java.lang.reflect.Field tableField = map.getClass().getDeclaredField("table");
        tableField.setAccessible(true);
        Object[] table = (Object[]) tableField.get(map);
        return table.length;
    }
}
上述代码展示了如何通过预计算容量来优化集合构建过程。在实际运行中,`goodSet` 会在初始化时直接分配足够大的桶数组,后续添加元素时几乎不会触发 `resize()` 方法。相比之下,`badSet` 会经历多次数组复制和重新哈希的过程。通过这种方式,我们可以消除动态扩容带来的 CPU 周期浪费和内存碎片问题。需要注意的是,如果预估容量过大,虽然避免了扩容,但会占用更多内存,因此平衡点在于尽可能接近实际使用的元素数量。
立即学习“Java免费学习笔记(深入)”;

为什么自定义对象必须重写 hashCode 和 equals
当 HashSet 中存储的是自定义对象而非基本类型或 String 等标准库类时,必须确保这些类正确实现了 hashCode 和 equals 方法。HashSet 依赖 hashCode 来确定对象在桶数组中的位置,如果两个逻辑上相等的对象返回不同的 hashCode,它们会被放入不同的桶中,导致 HashSet 无法识别它们是重复元素,从而造成内存泄漏和数据不一致。同时,equals 方法用于在同一个桶内比较对象是否真正相等。如果未重写这两个方法,Java 会使用默认的引用比较(==),这通常不符合业务逻辑上的“相等”定义。因此,对于任何作为 HashSet 键值的自定义类,都应生成基于关键属性的 hashCode 和 equals 实现,以保证集合行为的正确性和高效性。

import java.util.HashSet;
import java.util.Objects;
import java.util.Set;

public class CustomObjectExample {

    static class Person {
        private final String name;
        private final int age;

        public Person(String name, int age) {
            this.name = name;
            this.age = age;
        }

        // 必须重写 hashCode 和 equals
        @Override
        public int hashCode() {
            return Objects.hash(name, age);
        }

        @Override
        public boolean equals(Object o) {
            if (this == o) return true;
            if (o == null || getClass() != o.getClass()) return false;
            Person person = (Person) o;
            return age == person.age && Objects.equals(name, person.name);
        }
    }

    public static void main(String[] args) {
        Set<Person> people = new HashSet<>();

        Person p1 = new Person("Alice", 30);
        Person p2 = new Person("Alice", 30); // 逻辑上相同

        people.add(p1);
        people.add(p2);

        // 输出应为 1,因为 p1 和 p2 被视为同一元素
        System.out.println("Size: " + people.size());

        // 验证查找功能
        System.out.println("Contains p2: " + people.contains(p2)); // 输出 true
    }
}
在这个示例中,`Person` 类重写了 `hashCode` 和 `equals`,使得即使 `p1` 和 `p2` 是不同的对象实例,只要它们的 `name` 和 `age` 相同,就被视为重复元素。如果不重写这两个方法,`people.size()` 将会是 2,且 `contains(p2)` 可能返回 false,这违背了 Set 集合的唯一性语义。这种实现方式不仅保证了数据的完整性,还确保了哈希表在查找和插入时的效率,因为相同的对象会被映射到同一个桶中进行快速比对。
当 HashSet 中包含大量数据时如何优化遍历性能
当 HashSet 规模较大时,遍历操作的性能主要受到底层桶数组大小的影响。如果初始容量设置过小,即使添加了少量元素,也可能因为负载因子超过阈值而触发扩容,导致桶数组变大但许多桶为空。在遍历时,迭代器需要遍历整个桶数组,包括那些空的桶,这会带来不必要的开销。因此,在已知数据量较大的情况下,除了初始化时设置合理的容量外,还应考虑使用并行流(Parallel Stream)进行遍历处理,或者在 JDK 8+ 中使用 `forEach` 结合 Lambda 表达式以减少迭代器的对象创建开销。此外,如果遍历是为了过滤或转换数据,可以考虑直接使用 `stream()` 方法链式调用,利用短路求值和惰性求值特性提升整体执行效率。


















