








使用 fetch 请求 docx 接口时,必须将 responsetype 设置为 arraybuffer 或 blob,否则浏览器会尝试将其解析为文本导致文件损坏。拿到数据后,通过创建 url.createobjecturl 生成临时链接并触发下载,或者在内存中利用 jszip 等库进行解压处理。

如何正确获取二进制流并触发下载
直接调用 .blob() 方法是最稳妥的方式,它能保留完整的二进制结构。获取到 Blob 对象后,创建一个指向该对象的 URL,模拟用户点击链接的行为即可完成下载。
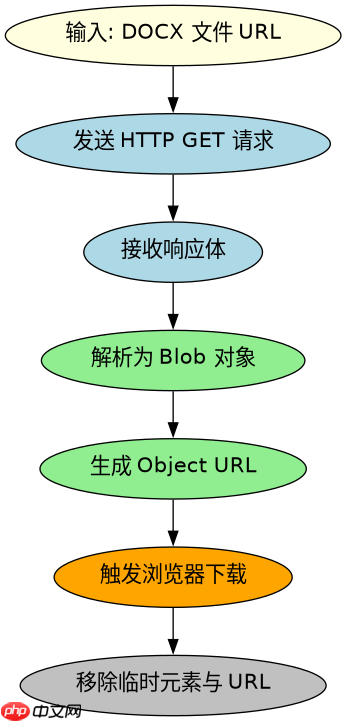
async function downloadDocx(url) {
  try {
    const response = await fetch(url);
    if (!response.ok) throw new Error('Network error');

    // 获取 Blob 对象
    const blob = await response.blob();

    // 创建临时下载链接
    const downloadUrl = URL.createObjectURL(blob);
    const a = document.createElement('a');
    a.href = downloadUrl;
    a.download = 'document.docx'; // 指定文件名
    document.body.appendChild(a);
    a.click();

    // 清理资源
    a.remove();
    URL.revokeObjectURL(downloadUrl);
  } catch (error) {
    console.error('Download failed:', error);
  }
}
运行上述代码后,浏览器会弹出保存对话框,保存的文件即为原始 DOCX 文档。如果直接读取 response.text(),返回的将是乱码字符串,无法用于后续处理。
立即学习“Java免费学习笔记(深入)”;

如何在内存中解析 DOCX 内部结构
DOCX 本质上是 ZIP 压缩包,包含 XML 和媒体文件。若需提取内容而非下载,应使用 JSZip 库加载 Blob 数据。通过 zip.file('word/document.xml').async('string') 可获取核心文本内容,再配合 DOMParser 解析 XML 节点。

import JSZip from 'jszip';

async function parseDocxContent(blob) {
  const zip = await JSZip.loadAsync(blob);
  const xmlFile = zip.file('word/document.xml');

  if (!xmlFile) {
    throw new Error('Invalid DOCX structure');
  }

  const xmlString = await xmlFile.async('string');
  const parser = new DOMParser();
  const xmlDoc = parser.parseFromString(xmlString, 'text/xml');

  // 提取所有 w:t 节点内的文本
  const textNodes = xmlDoc.getElementsByTagName('w:t');
  let content = '';
  for (let i = 0; i < textNodes.length; i++) {
    content += textNodes[i].textContent;
  }

  return content;
}
此方法适用于需要预览或分析文档内容的场景。注意 DOCX 中的换行、表格等格式信息分散在不同 XML 标签中,简单拼接 w:t 内容仅能获得纯文本,丢失了排版信息。
如何处理大文件导致的内存溢出问题
当 DOCX 文件超过几十 MB 时,一次性加载到内存可能引发 OutOfMemoryError。此时应避免使用 loadAsync 全量加载,改用流式处理或分块读取。对于仅需提取部分内容的场景,可先检查 zip.files 键值是否存在,再按需加载特定文件。


















