








带索引的字段在sql中update会导致性能剧降,核心原因是数据库不仅要更新数据行本身,还必须同步维护所有关联的索引结构。当执行更新操作时,如果新值导致索引顺序变化(如b+树节点分裂),或者需要删除旧索引条目并插入新条目,数据库会触发大量的随机i/o和页分裂操作,这会显著增加锁竞争和磁盘写入开销。
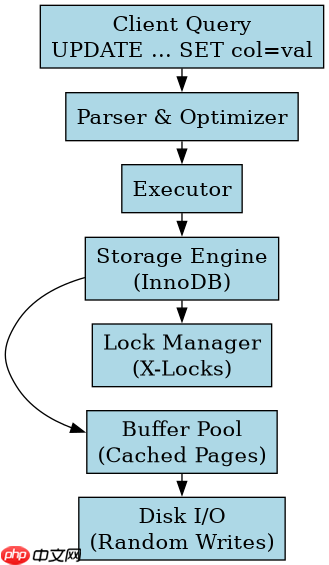
B+树索引在更新时的内部结构变化
以最常见的B+树索引为例,当更新一个非唯一索引列的值时,数据库引擎通常采用“删除旧键、插入新键”的策略。如果新值的大小或排序位置与原值差异较大,可能会导致当前叶子节点无法容纳新记录,从而引发页分裂(Page Split)。页分裂不仅涉及内存中数据结构的重排,还需要同步将新的页面刷入磁盘,这种随机写操作是性能瓶颈的主要来源。
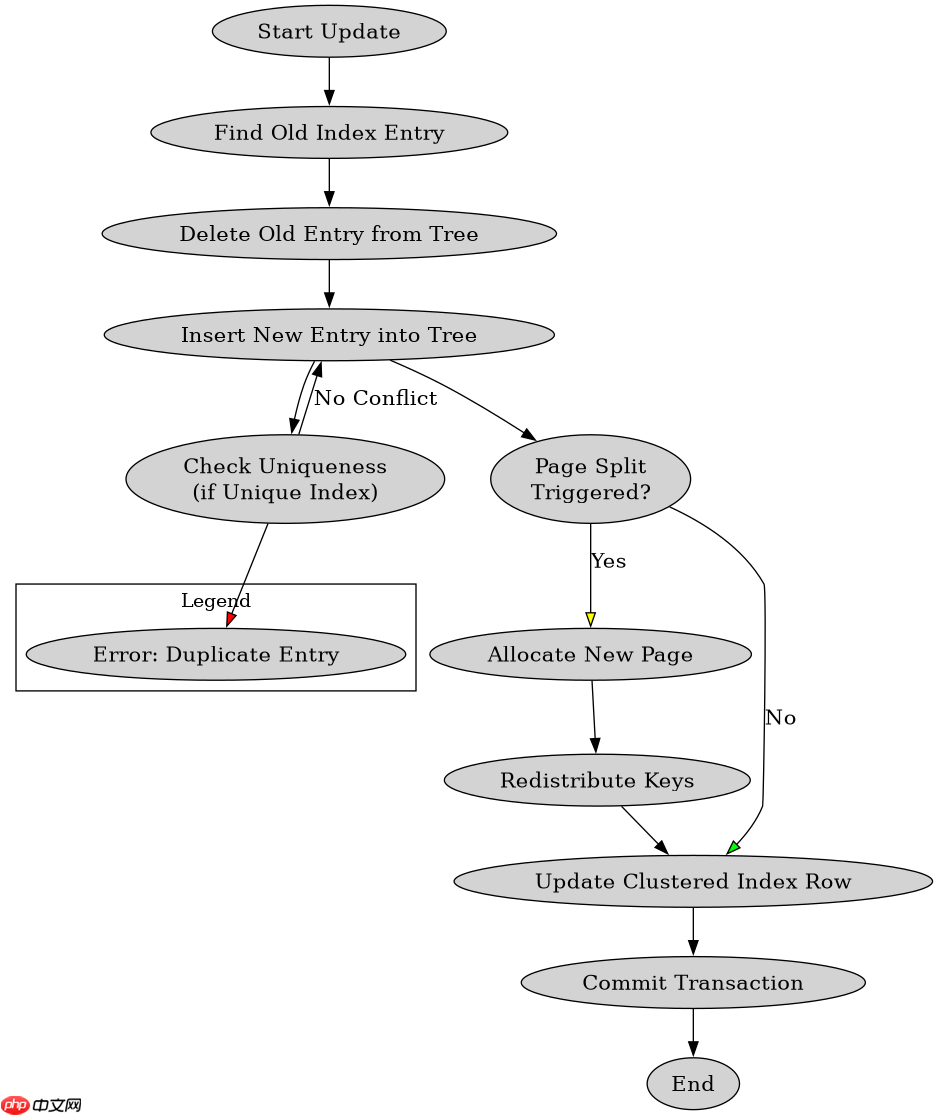
CREATE TABLE users (
  id INT PRIMARY KEY,
  name VARCHAR(50),
  age INT,
  INDEX idx_age (age)
);

-- 假设初始状态:age=20 存储在 Page A
-- 执行更新:SET age = 80
-- 结果:
-- 1. 从 idx_age 中删除 (20, id)
-- 2. 尝试在 idx_age 中插入 (80, id)
-- 3. 若目标页满,触发页分裂,生成新 Page B
-- 4. 更新聚簇索引对应的数据行
-- 5. 提交事务,刷新日志与缓冲池
唯一索引与非唯一索引的更新差异
唯一索引和非唯一索引在更新时的行为有细微但关键的区别。对于唯一索引,数据库在执行更新前必须先检查新值是否已存在,这引入了额外的查找开销。如果新值重复,还会抛出主键或唯一约束冲突异常,导致事务回滚。而非唯一索引则直接进行物理位置的调整。此外,如果更新的字段是索引的前导列,整个索引树的遍历路径可能完全改变,导致更多的缓存失效。
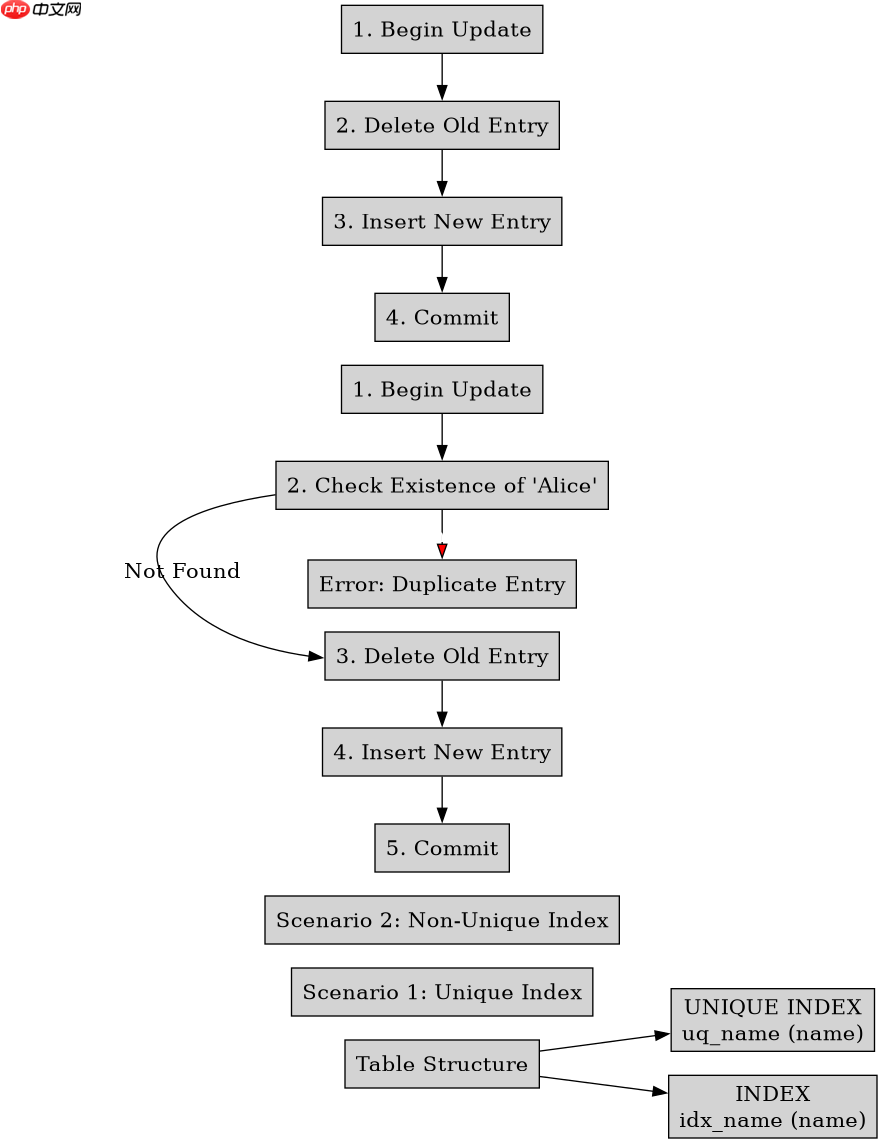
-- 对比测试:唯一索引 vs 非唯一索引
-- 表结构相同,仅索引类型不同

-- 场景1:唯一索引
ALTER TABLE users ADD UNIQUE INDEX uq_name (name);
UPDATE users SET name = 'Alice' WHERE id = 1;
-- 行为:先查询 name='Alice' 是否存在 -> 若存在则报错 -> 否则删除旧值插入新值

-- 场景2:非唯一索引
ALTER TABLE users DROP INDEX uq_name;
ALTER TABLE users ADD INDEX idx_name (name);
UPDATE users SET name = 'Alice' WHERE id = 1;
-- 行为:直接定位旧索引项 -> 删除 -> 插入新索引项 -> 无额外查重开销

-- 预期结果:
-- 场景1的执行时间通常略长于场景2,尤其在并发高时,因需持有更长的共享锁进行查重。
-- 若发生重复,场景1将返回错误码 1062 (Duplicate entry)。
大事务中批量更新对索引维护的影响
当在一个大事务中批量更新大量带有索引的字段时,性能下降尤为明显。这是因为每个更新操作都会产生相应的Undo Log和Redo Log。如果更新导致频繁的页分裂,Buffer Pool中的热点页会被不断修改,造成严重的Lru列表抖动。同时,由于事务未提交,其他读取该索引的事务可能需要等待锁释放,或者通过MVCC机制读取旧版本数据,增加了系统负担。建议在批量更新时,考虑暂时禁用索引或在低峰期执行,以减少对在线业务的影响。


















