








java jdbc 实现批量数据迁移的核心做法是关闭自动提交,将 sql 加入批处理队列,并在适当时机统一执行和提交。具体而言,调用 connection.setautocommit(false) 禁用自动事务,使用 preparedstatement.addbatch() 累积操作,通过 executebatch() 触发实际执行,最后调用 commit() 完成持久化。若中途发生异常,需立即回滚以保障数据一致性。

JDBC 批量操作的事务控制流程是怎样的
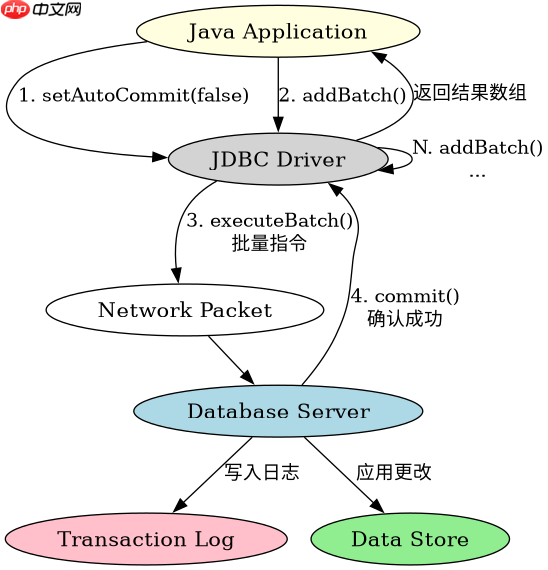
JDBC 批量操作的事务控制依赖于连接对象的自动提交状态与显式的事务管理方法。当自动提交关闭后,所有执行的 SQL 语句都会暂存在事务上下文中,直到遇到 commit() 或 rollback() 指令。这种机制允许我们将成千上万条记录打包处理,既减少了网络往返开销,又保证了操作的原子性。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class BatchMigration {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        // 模拟源数据
        String[] names = {"Alice", "Bob", "Charlie", "David"};

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            // 1. 关闭自动提交
            conn.setAutoCommit(false);

            String sql = "INSERT INTO users (name) VALUES (?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (String name : names) {
                    pstmt.setString(1, name);
                    pstmt.addBatch(); // 加入批处理
                }
                // 2. 执行批量操作
                int[] results = pstmt.executeBatch();
                // 3. 提交事务
                conn.commit();
                System.out.println("批量插入成功,共处理 " + results.length + " 条记录");
            } catch (SQLException e) {
                // 4. 异常时回滚
                conn.rollback();
                throw e;
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
上述代码展示了标准的批量插入流程。首先获取数据库连接并禁用自动提交。接着创建预编译语句,在循环中不断调用 addBatch() 将参数加入队列。循环结束后,调用 executeBatch() 一次性发送给数据库执行。如果执行过程中没有抛出异常,则调用 commit() 使更改生效;否则进入 catch 块执行 rollback() 撤销所有已做的更改。
立即学习“Java免费学习笔记(深入)”;

如何优化大批量迁移的性能与内存占用
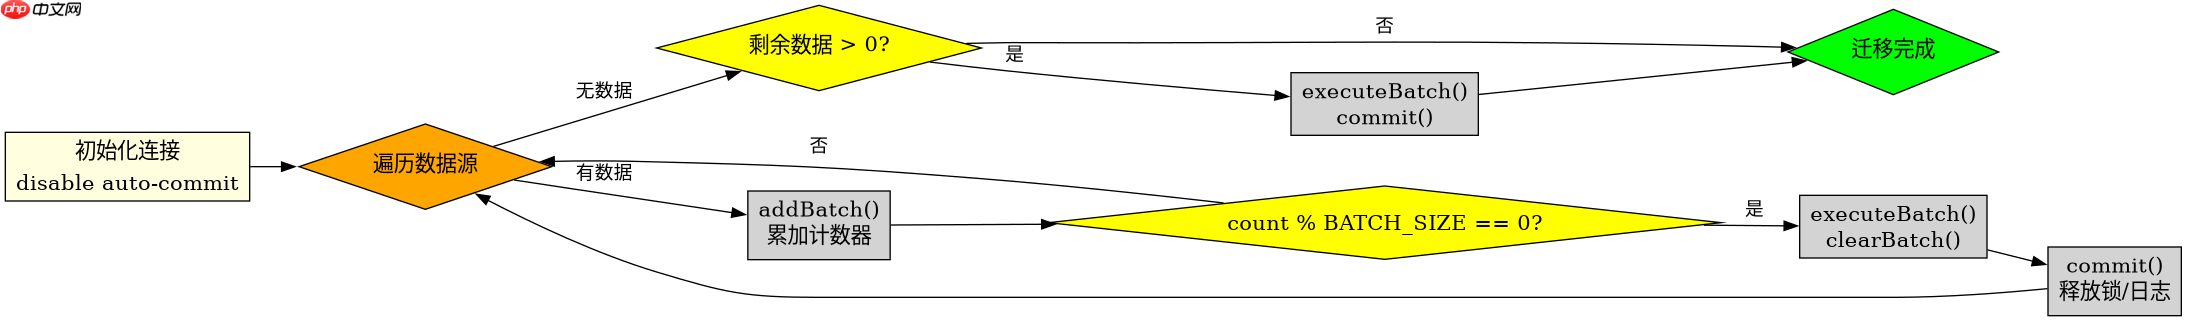
在处理百万级数据迁移时,一次性将所有数据加载到内存会导致 OutOfMemoryError,且长事务可能引发锁表或日志膨胀。优化的核心策略是分批次提交(Chunking)和调整 JDBC 驱动的参数。通过将数据切分为固定大小的块(如 1000 条),每处理完一块就提交一次事务,可以有效控制内存峰值和事务日志的大小。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;
import java.util.ArrayList;
import java.util.List;

public class OptimizedBatchMigration {
    private static final int BATCH_SIZE = 1000;

    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb?rewriteBatchedStatements=true";
        String user = "root";
        String password = "password";

        // 模拟大量数据
        List<String> allData = new ArrayList<>();
        for (int i = 0; i < 5000; i++) {
            allData.add("User_" + i);
        }

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            String sql = "INSERT INTO users (name) VALUES (?)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                int count = 0;
                for (String data : allData) {
                    pstmt.setString(1, data);
                    pstmt.addBatch();
                    count++;

                    // 达到批次大小时执行并提交
                    if (count % BATCH_SIZE == 0) {
                        pstmt.executeBatch();
                        conn.commit();
                        pstmt.clearBatch(); // 清空批处理队列
                        System.out.println("已提交批次:" + (count / BATCH_SIZE));
                    }
                }
                // 处理剩余不足一批的数据
                if (count % BATCH_SIZE != 0) {
                    pstmt.executeBatch();
                    conn.commit();
                }
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
该优化版本引入了 BATCH_SIZE 常量来控制每次提交的记录数。在循环内部,每当累计数量达到阈值时,便执行 executeBatch() 并立即 commit()。关键在于调用 pstmt.clearBatch() 清理已发送的指令,防止内存堆积。同时,URL 中添加了 rewriteBatchedStatements=true 参数,这会让 MySQL 驱动将多个单条 INSERT 合并为一条多值 INSERT 语句,进一步提升吞吐量。对于最后剩余不足一批的数据,单独执行一次以确保完整性。
批量操作中遇到主键冲突应如何处理
在数据迁移场景中,目标表往往已经存在部分数据或具有唯一约束,直接插入可能导致 DuplicateKeyException。处理此类问题的标准做法是利用数据库提供的 INSERT IGNORE 或 ON DUPLICATE KEY UPDATE 语法。JDBC 批量操作本身不改变 SQL 语义,因此只需修改 SQL 模板即可优雅地解决冲突,避免程序因异常而中断整个迁移过程。
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.PreparedStatement;
import java.sql.SQLException;

public class ConflictHandlingBatch {
    public static void main(String[] args) {
        String url = "jdbc:mysql://localhost:3306/mydb";
        String user = "root";
        String password = "password";

        String[] names = {"Alice", "Bob", "Alice"}; // Alice 重复

        try (Connection conn = DriverManager.getConnection(url, user, password)) {
            conn.setAutoCommit(false);
            // 使用 ON DUPLICATE KEY UPDATE 处理冲突
            String sql = "INSERT INTO users (id, name) VALUES (?, ?) " +
                         "ON DUPLICATE KEY UPDATE name = VALUES(name)";
            try (PreparedStatement pstmt = conn.prepareStatement(sql)) {
                for (int i = 0; i < names.length; i++) {
                    pstmt.setInt(1, i + 1); // 假设 id 为主键
                    pstmt.setString(2, names[i]);
                    pstmt.addBatch();
                }
                int[] results = pstmt.executeBatch();
                conn.commit();
                System.out.println("处理完成,结果数组长度:" + results.length);
            } catch (SQLException e) {
                conn.rollback();
                e.printStackTrace();
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
在此示例中,SQL 语句使用了 MySQL 特有的 ON DUPLICATE KEY UPDATE 子句。当插入的记录导致主键或唯一索引冲突时,数据库不会报错,而是执行更新操作。JDBC 驱动依然按正常批量流程处理,executeBatch() 返回的结果数组包含每条语句影响的行数。对于冲突行,影响行数通常为 2(更新);对于新行,通常为 1(插入)。这种方式比在 Java 层先查询再决定插入或更新要高效得多,因为它将逻辑下推到了数据库引擎。



















