








在java中使用lambda表达式配合files.walk进行文件遍历,核心方法是调用stream的filter和foreach方法。通过传入predicate过滤路径,并在consumer中处理匹配的文件,可以简洁地实现递归目录扫描。需要注意的是files.walk默认是懒加载的,必须确保stream在使用后关闭,通常使用try-with-resources语句包裹。

如何过滤特定后缀的文件
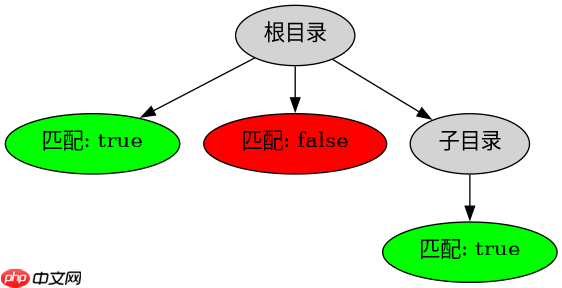
要筛选特定类型的文件,需要在walk生成的Stream上链式调用filter方法。该方法接收一个Path对象作为输入,返回布尔值决定该路径是否保留。例如,只处理.java文件时,可以使用endsWith判断扩展名。结合forEach即可对每个匹配项执行操作。
import java.nio.file.*;
import java.io.IOException;

public class Main {
    public static void main(String[] args) throws IOException {
        Path start = Paths.get(".");
        try (Stream<Path> stream = Files.walk(start)) {
            stream.filter(p -> p.toString().endsWith(".java"))
                  .forEach(p -> System.out.println(p));
        }
    }
}
如何处理遍历中的异常
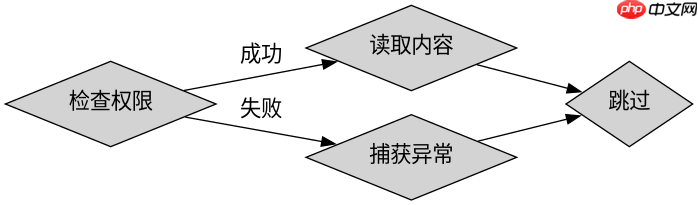
Files.walk在访问受限目录时会抛出AccessDeniedException。由于Lambda表达式内部不能直接抛出受检异常,需要在lambda体内捕获异常并处理,或者使用自定义函数包装。建议在forEach或map操作中捕获IOException,避免整个流中断。

立即学习“Java免费学习笔记(深入)”;
import java.nio.file.*;
import java.io.IOException;

public class Main {
    public static void main(String[] args) throws IOException {
        Path start = Paths.get(".");
        try (Stream<Path> stream = Files.walk(start)) {
            stream.forEach(p -> {
                try {
                    if (Files.isRegularFile(p)) {
                        System.out.println(Files.size(p));
                    }
                } catch (IOException e) {
                    System.err.println("Error: " + e.getMessage());
                }
            });
        }
    }
}
Files.walk深度限制的具体表现是什么
Files.walk默认会无限递归直到文件系统叶子节点。如果目录结构极深,可能导致StackOverflowError或内存溢出。可以通过limit方法限制遍历的深度或数量,防止资源耗尽。例如limit(10)只处理前10个路径。

















