在sql server中优化包含聚合函数的索引,核心策略是使用覆盖索引(covering index)将查询所需的列全部放入索引结构中,从而避免回表操作。具体做法是在where子句涉及的列上建立前导键,并将select列表中的非键列通过include关键字加入索引的叶级节点。这样做的结果是数据库引擎可以直接从索引树中读取数据完成聚合计算,无需访问堆表或聚集索引,显著提升查询性能。
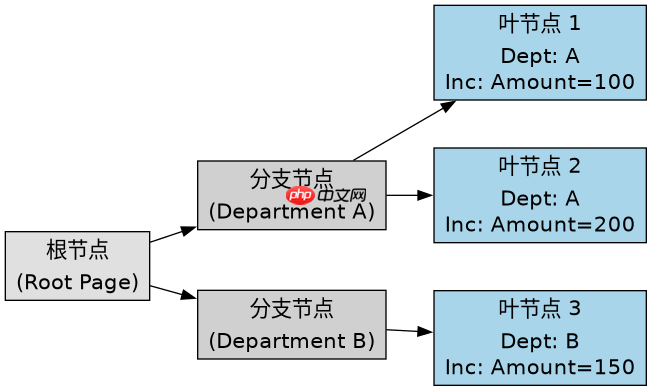
如何设计包含GROUP BY和SUM的覆盖索引
当查询涉及分组和求和时,应将分组列作为索引的前导键,并将需要聚合的数值列包含在索引中。例如,对于按部门统计销售额的场景,创建以DepartmentId为键、Amount为包含列的非聚集索引,可以完全覆盖该查询。这种设计让SQL Server能够执行Index Scan或Index Seek并直接进行Stream Aggregate,避免了昂贵的Key Lookup操作。
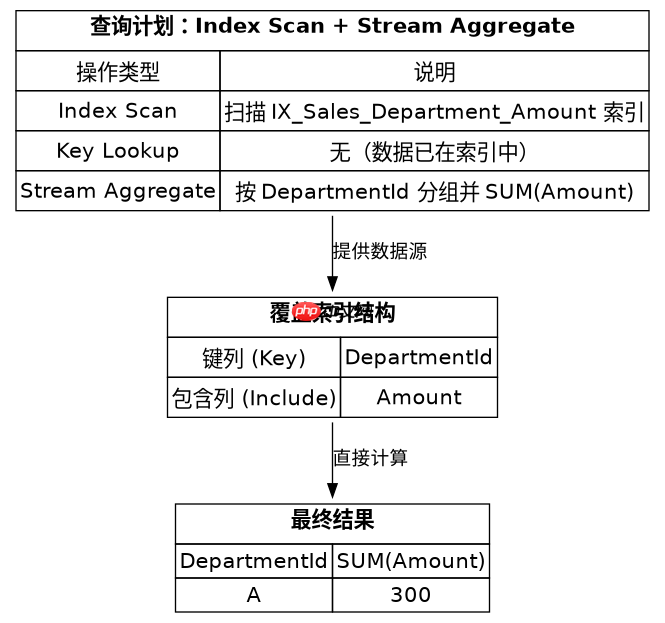
CREATE NONCLUSTERED INDEX IX_Sales_Department_Amount
ON Sales (DepartmentId)
INCLUDE (Amount);
上述代码创建了针对Sales表的覆盖索引。执行SELECT DepartmentId, SUM(Amount) FROM Sales GROUP BY DepartmentId时,优化器会选择此索引。因为所有需要的数据都在索引叶节点中,查询计划中不会出现Clustered Index Seek或Key Lookup,从而减少了I/O开销。
如何处理包含多个聚合函数如COUNT和AVG的查询
如果查询同时需要COUNT和AVG等聚合函数,且这些函数作用于同一组分组列,覆盖索引的设计原则依然适用。只需确保索引的前导键包含所有GROUP BY列,并通过INCLUDE添加所有被聚合的列即可。即使聚合函数不同,只要数据来源列相同,同一个覆盖索引就能满足需求。关键在于索引必须包含计算结果所需的所有原始数据列。
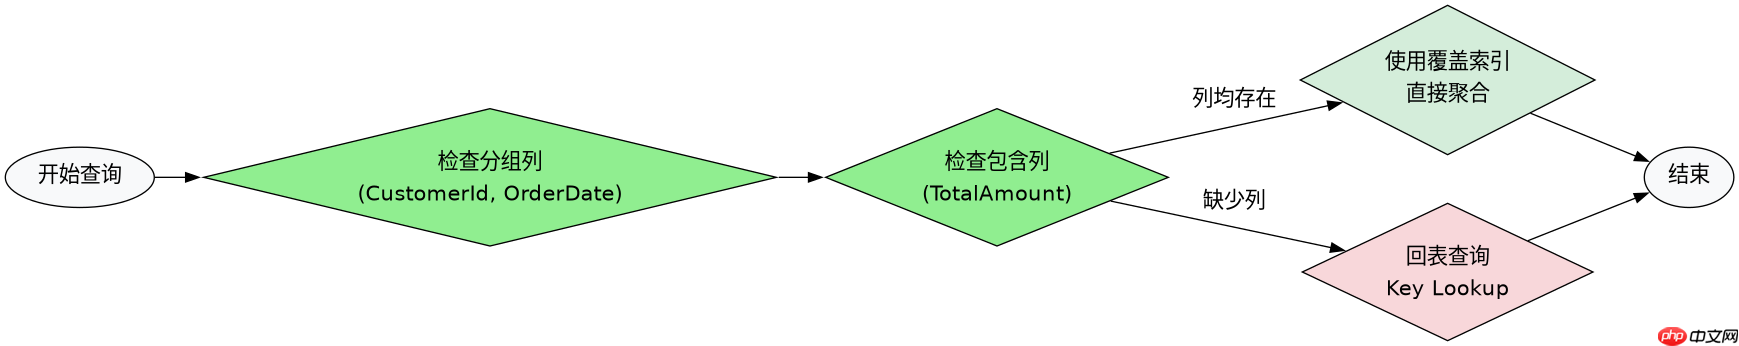
CREATE NONCLUSTERED INDEX IX_Orders_Customer_Date_Total
ON Orders (CustomerId, OrderDate)
INCLUDE (TotalAmount);
该索引覆盖了按客户和日期统计订单总额及平均金额的查询。执行SELECT CustomerId, COUNT(*) as cnt, AVG(TotalAmount) FROM Orders GROUP BY CustomerId, OrderDate时,数据库可直接利用索引中的TotalAmount列计算平均值,并利用行数计算计数。由于所有数据均在索引中,查询效率达到最优,消除了对基表数据的随机访问。
在包含大量重复值的分组列上使用覆盖索引的效果如何
当分组列存在大量重复值时,覆盖索引的优势更加明显。因为SQL Server需要在内存中对分组后的数据进行聚合,如果数据不在索引中,每次聚合后都需要回表获取其他列,这会引发大量的随机I/O。使用覆盖索引后,所有数据预加载到索引页中,聚合过程完全在内存和缓存中进行,大幅降低了磁盘I/O。此外,高重复值意味着分组数量相对较少,索引查找范围更集中,进一步提升了速度。