








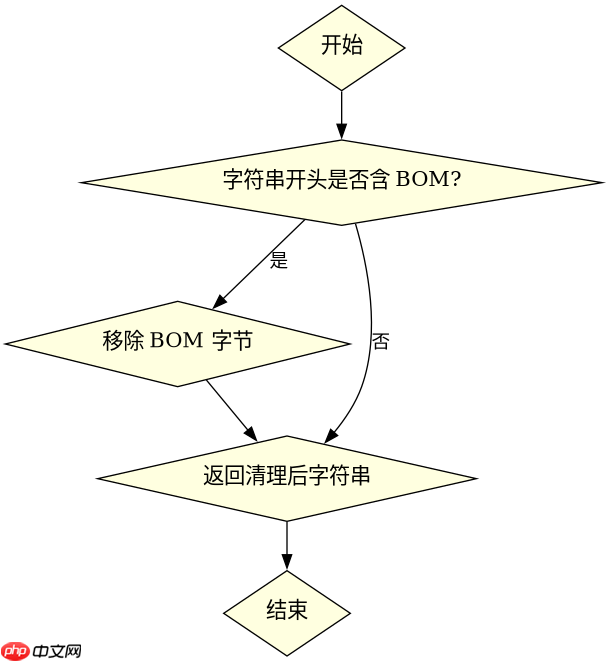
使用 ltrim() 函数并指定 utf-8 bom 的字节序列作为过滤字符,即可去除字符串开头的 bom 头。具体做法是将十六进制值 \xef\xbb\xbf 传入 ltrim() 的第二个参数,该函数会移除字符串左侧所有出现在此字符集中的字符,从而精准清除 bom 而不影响其他内容。

ltrim() 处理 BOM 的具体机制是什么
ltrim() 通过匹配指定字符集来修剪字符串左侧空白或特定符号。对于 UTF-8 BOM,其对应的字节序列是 \xEF\xBB\xBF。当将此序列作为第二个参数传入时,函数会检查字符串开头是否包含这些字节,若存在则将其移除。这种方法比正则表达式更轻量,且不会误伤正常文本中的相同字节组合(除非它们位于字符串最左侧且连续出现)。
$string = "\xEF\xBB\xBFHello World";
$cleaned = ltrim($string, "\xEF\xBB\xBF");
echo $cleaned; // 输出: Hello World
上述代码展示了实际调用过程。输入字符串包含 BOM 前缀,经过 ltrim() 处理后,BOM 被移除,剩余部分保持原样。预期结果为 Hello World,类型为 string。若输入无 BOM,则返回原字符串,行为一致。
立即学习“PHP免费学习笔记(深入)”;

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
如果 BOM 不是 UTF-8 格式,该如何处理
不同编码的 BOM 对应不同的字节序列。UTF-16 BE 的 BOM 为 \xFE\xFF,UTF-16 LE 为 \xFF\xFE,UTF-32 BE 为 \x00\x00\xFE\xFF,UTF-32 LE 为 \xFF\xFE\x00\x00。可根据实际编码选择对应的字节序列传入 ltrim()。例如,若已知文件为 UTF-16 BE 编码,可使用 ltrim($string, "\xFE\xFF") 进行清理。

$utf16be_bom = "\xFE\xFF";
$string = $utf16be_bom . "Hello";
$cleaned = ltrim($string, $utf16be_bom);
echo $cleaned; // 输出: Hello
此示例针对 UTF-16 BE 编码场景。输入包含该编码的 BOM,ltrim() 移除后得到纯净文本。预期输出为 Hello,类型仍为 string。注意:若编码未知,建议先检测编码再决定使用哪种 BOM 序列,避免错误修剪。
如何验证 BOM 是否已被成功去除
可通过比较原始字符串与清理后字符串的长度或字节内容来验证。若原始字符串长度大于清理后字符串,且差值等于 BOM 字节数,则说明 BOM 已被移除。也可使用 bin2hex() 查看十六进制表示,确认开头不再含有 BOM 特征码。
$original = "\xEF\xBB\xBFTest";
$cleaned = ltrim($original, "\xEF\xBB\xBF");
if (strlen($original) > strlen($cleaned)) {
    echo "BOM removed successfully.";
} else {
    echo "No BOM found or removal failed.";
}
该验证逻辑基于长度差异判断。输入含 BOM 的字符串,经 ltrim() 处理后,长度减少 3 字节(UTF-8 BOM 长度),条件成立,输出提示信息。若输入无 BOM,长度不变,输出失败提示。此方法可靠且无需额外依赖。



















