








在java中,使用编码声明避免解析错误的核心做法是:在读取外部数据(如文件、网络流)时,显式指定字符集;在生成输出(如html、xml)时,通过http头或元标签声明编码。如果不这样做,系统默认可能使用平台相关编码(如gbk),导致中文乱码或解析异常。
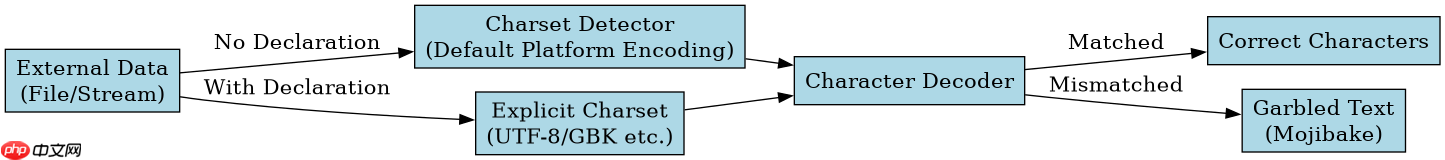
如何正确读取UTF-8编码的文件
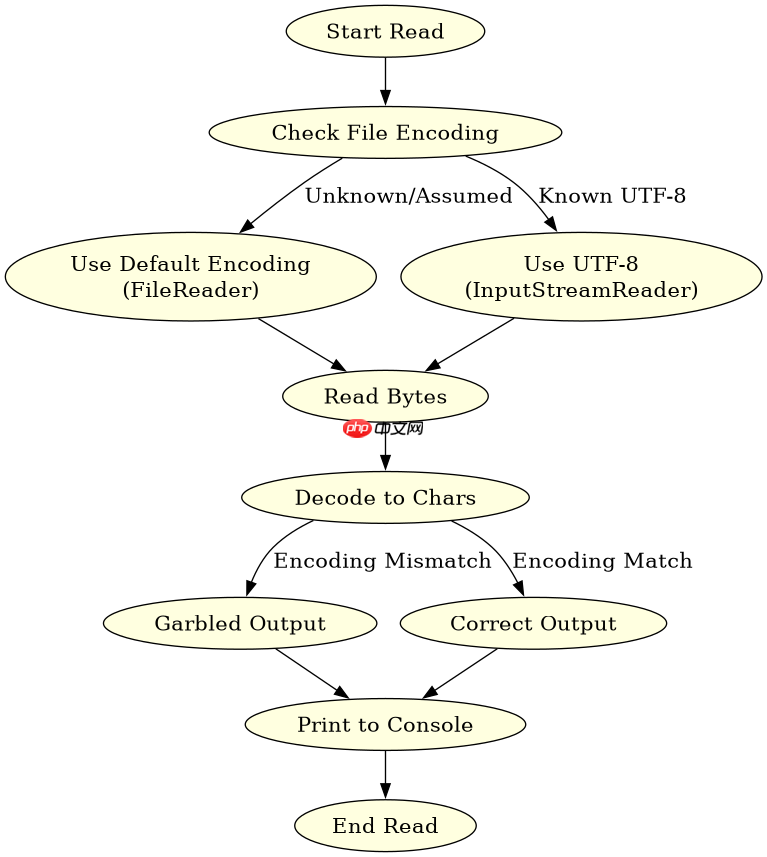
直接回答:使用InputStreamReader并传入StandardCharsets.UTF_8即可正确读取UTF-8文件。关键在于不要依赖无参构造函数,因为那会使用平台默认编码。如果文件包含BOM,可能需要额外处理跳过前三个字节。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class FileReadDemo {
    public static void main(String[] args) throws IOException {
        // 假设有一个UTF-8编码的文本文件
        String filePath = "data.txt";

        // 错误写法:使用平台默认编码,可能在Windows上变成GBK导致乱码
        // BufferedReader reader = new BufferedReader(new FileReader(filePath));

        // 正确写法:显式指定UTF-8
        try (BufferedReader reader = new BufferedReader(
                new InputStreamReader(new FileInputStream(filePath), StandardCharsets.UTF_8))) {
            String line;
            while ((line = reader.readLine()) != null) {
                System.out.println(line);
            }
        }
    }
}
预期结果:控制台正确打印文件中所有中文字符,无乱码。若文件为GBK编码而强制用UTF-8读取,则会出现乱码。
立即学习“Java免费学习笔记(深入)”;
如何在HTTP响应中声明编码以避免浏览器解析错误
直接回答:在Servlet或Spring MVC中,通过设置响应头Content-Type并包含charset=UTF-8参数,可以明确告知浏览器使用UTF-8解码响应体。这比依赖HTML内部的标签更可靠,因为浏览器在解析HTML之前就需要知道编码来正确显示内容。


import javax.servlet.http.*;
import java.io.IOException;

public class ServletResponseDemo extends HttpServlet {
    @Override
    protected void doGet(HttpServletRequest req, HttpServletResponse resp)
            throws ServletException, IOException {
        // 关键步骤:设置Content-Type并声明charset
        resp.setContentType("text/html;charset=UTF-8");

        PrintWriter out = resp.getWriter();
        out.println("<html><body>");
        out.println("<h1>中文测试</h1>");
        out.println("<p>这是UTF-8编码的内容</p>");
        out.println("</body></html>");
    }
}
预期结果:浏览器以UTF-8解码响应体,中文正常显示。若未声明charset,浏览器可能猜测编码(如GBK),导致乱码。
当输入流中包含BOM标记时会发生什么
直接回答:如果UTF-8文件包含BOM(Byte Order Mark,即EF BB BF),使用InputStreamReader读取时,BOM会被当作第一个字符返回,可能导致字符串开头出现不可见字符“”,影响后续字符串比较或JSON解析。解决方法是使用BomInputStream或手动跳过前三个字节。
import java.io.*;
import java.nio.charset.StandardCharsets;

public class BOMHandlingDemo {
    public static void main(String[] args) throws IOException {
        String filePath = "bom_file.txt"; // 包含UTF-8 BOM的文件

        try (InputStream is = new FileInputStream(filePath)) {
            // 检查BOM
            if (is.read() == 0xEF && is.read() == 0xBB && is.read() == 0xBF) {
                // 跳过BOM
            } else {
                // 如果不是BOM,需要重新读取或重置流
                throw new IOException("Not a UTF-8 BOM file");
            }

            // 继续读取剩余内容
            try (BufferedReader reader = new BufferedReader(
                    new InputStreamReader(is, StandardCharsets.UTF_8))) {
                String content = reader.readLine();
                System.out.println("Content: [" + content + "]"); // 开头无BOM字符
            }
        }
    }
}
预期结果:控制台输出的字符串开头不包含BOM字符,确保与纯文本一致。若未处理BOM,字符串开头会多出一个不可见字符。



















